论文解读 语音 AI 抑郁检测 多特征融合

用声音识别抑郁:AI 在"听"什么?

ABAFnet 融合 4 类声学特征,在临床中文朗读语音上达到 AUC 0.85 ± 0.04

Neurocomputing, 2024, 601, 128209

4 类声学特征通道
0.85融合 AUC(±0.04)
6 552维 HSF 统计特征
87.5 %关键特征来自 Mel/MFCC
30 秒速览

一段朗读,四重"听诊"

类比:抑郁的评估常靠访谈和量表,耗时且受主观影响。ABAFnet 像一位同时戴着四副"听诊器"的 AI——分别听声音的能量起伏、频率纹理、人耳感知频谱和6 552 维统计指标,再用注意力机制把"最值得听"的信号放大。在临床中文朗读数据 CNRAC 上,融合模型 AUC 0.85、ACC 0.81,优于任何单一特征,表明多角度线索融合可为语音辅助筛查带来更稳定的信号。
研究背景

为什么要让 AI "听"抑郁?

COVID-19 后抑郁病例上升,传统量表评估耗时且受回忆偏差影响。语音是一种低负担行为标记——抑郁人群在单调度、语速、韵律等方面可能出现差异,但过去方法多依赖单一维度特征,可能忽略语音"多层次"信息。不同特征的形态与尺寸差异很大,直接拼接并不容易。ABAFnet 试图解决两个问题:如何分别提取不同角度的声音线索,以及如何让模型自己学会给每个角度分配合适的权重。
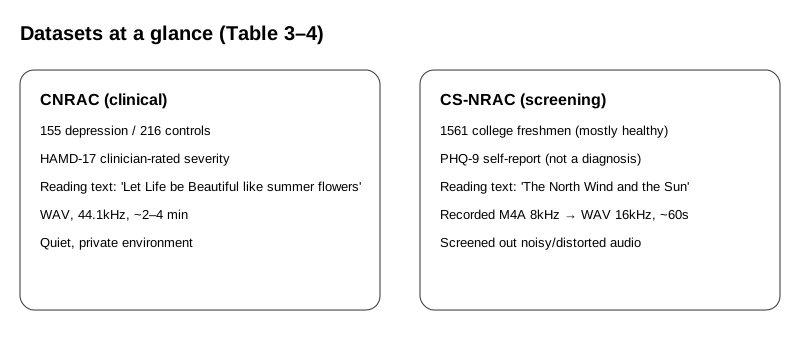
数据集概览
两套数据集:临床 CNRAC 与社区筛查 CS-NRAC,分别提供朗读语音与 PHQ-9 在线自评。
研究方法

四副"听诊器" + 动态加权融合

把一段朗读语音想成一部"电影":它既有随时间变化的剧情,也有不同频率上的"画面纹理"。ABAFnet 从四个角度"截屏",再让模型学会在不同情境下给每个角度分配合适的权重。

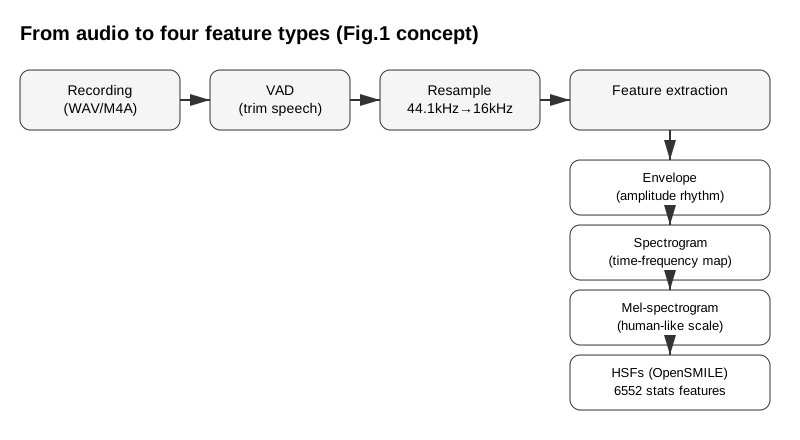
Envelope声音能量随时间的起伏曲线,反映节奏与能量变化
Spectrogram时间×频率热力图,捕捉频率结构如何随时间变化
Mel-spectrogram人耳感知频率刻度,更容易抓到细微变化
HSFs(6 552 维)OpenSMILE 提取的语音学统计指标"体检报告"

三大核心模块

1

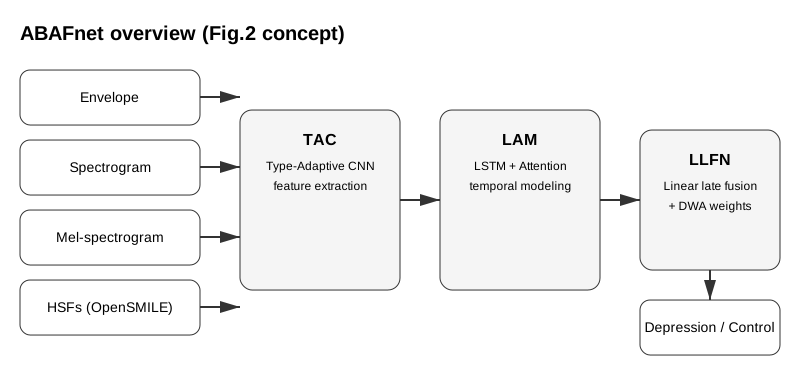
TAC

Type-Adaptive CNN:对"图像型"与"向量型"特征分别用不同卷积方式处理,像给不同材料选不同刀具

2

LAM

LSTM + Attention:用 LSTM 捕捉长短期依赖,再用注意力对关键时间片段高亮

3

LLFN + DWA

线性融合 + 动态权重:权重不固定,根据训练评价指标自动调整各通道重要性

ABAFnet 架构示意
ABAFnet 架构:四路特征分别经过 TAC → LAM,再经 LLFN + DWA 动态融合输出判断。
处理流程
完整处理流程:原始录音 → VAD 去噪 → 重采样 → 四路特征提取 → 融合分类。
核心发现

发现 1:四特征融合 > 任何单一特征

多角度融合带来最稳表现

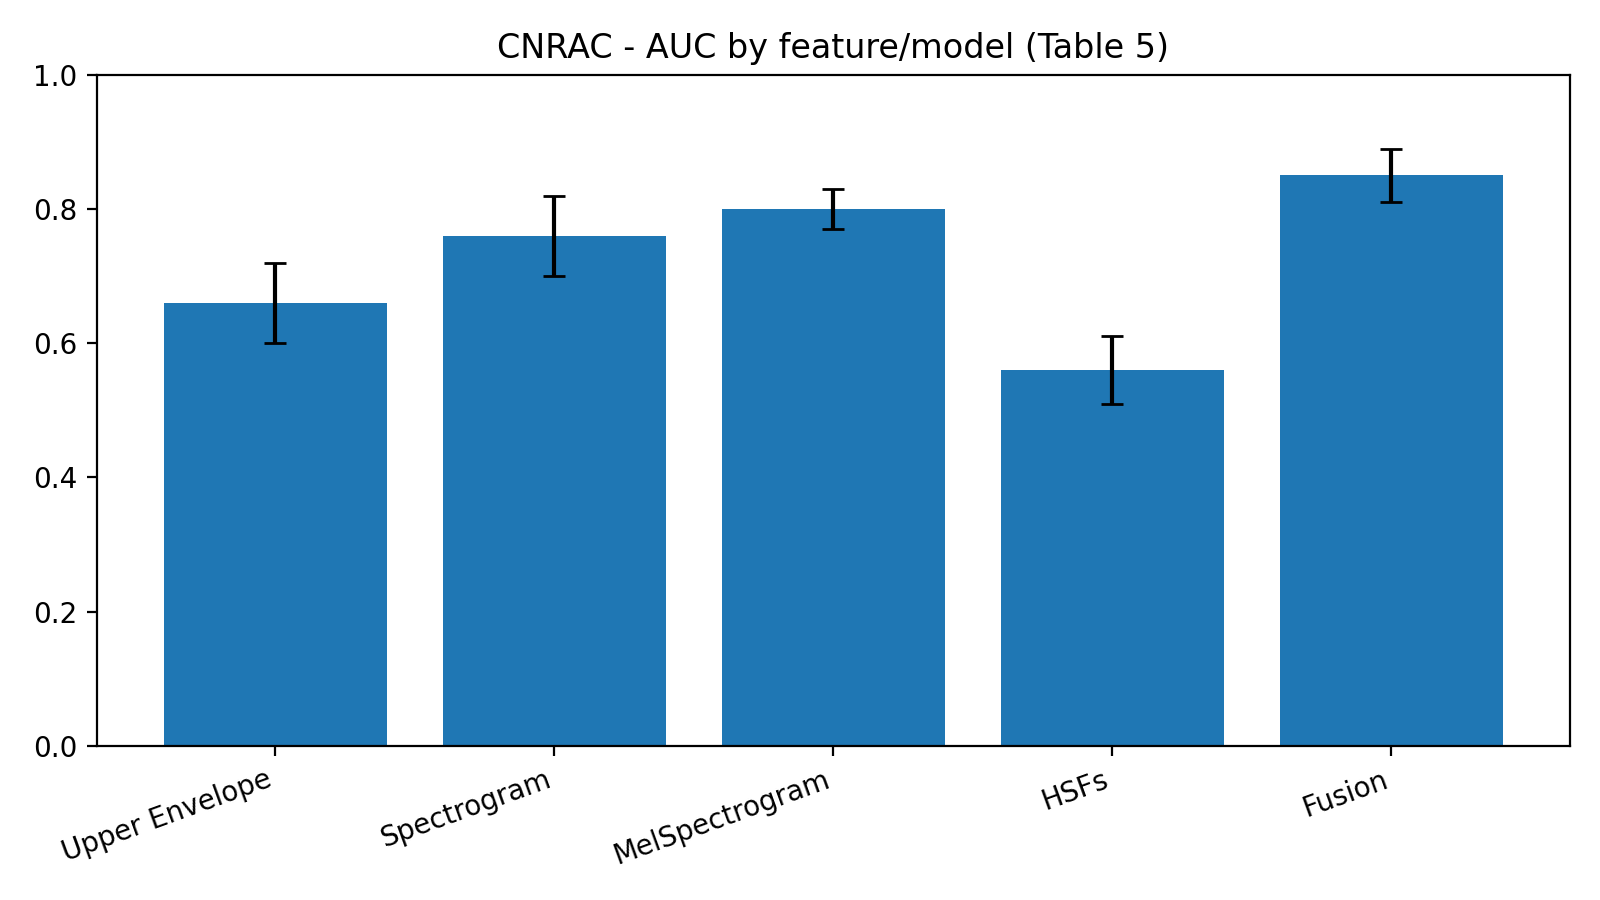
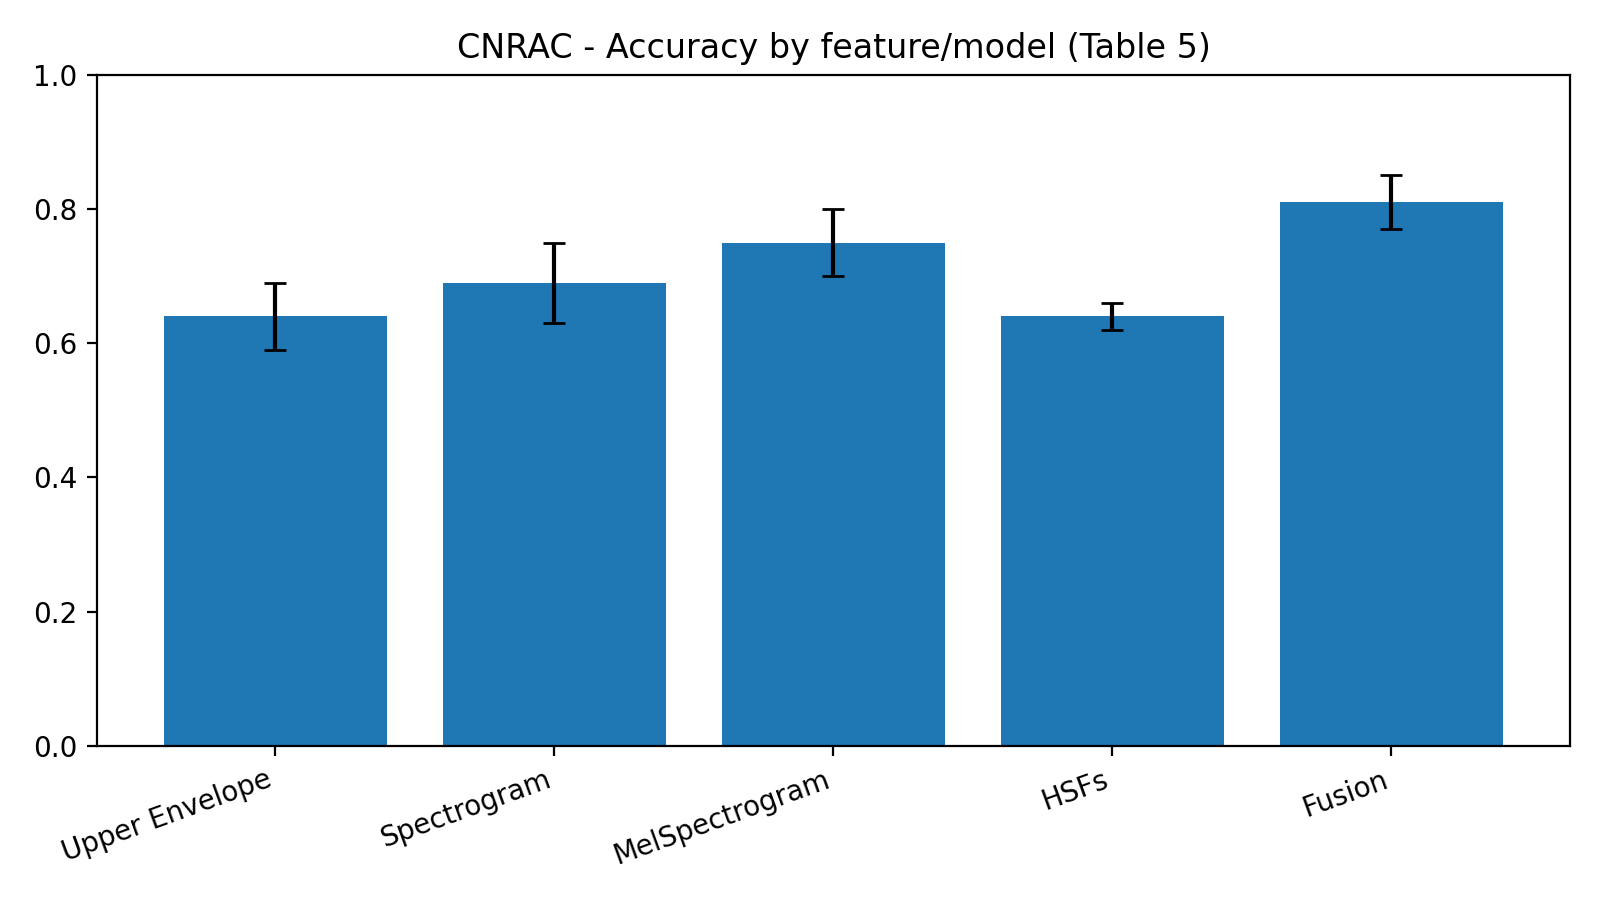
只看一种"声音线索"不够稳。融合后 ACC 0.81±0.04、AUC 0.85±0.04;而单一特征中表现最好的 Mel-spectrogram 仅达 ACC 0.75±0.05、AUC 0.80±0.03。不同特征携带互补信息,融合策略更适合真实语音里复杂、异质的抑郁线索。

融合(ABAFnet)
0.85
Mel-spectrogram
0.80
Spectrogram
0.76
Envelope
0.73
HSFs
0.71

AUC 对比(CNRAC 二分类,10 折交叉验证均值)

AUC 对比表
表 5:各特征及融合模型在 CNRAC 上的 AUC 对比。
ACC 对比表
表 5:各特征及融合模型在 CNRAC 上的 ACC 对比。

发现 2:区分严重度更难,但"健康 vs 中重度"信号强

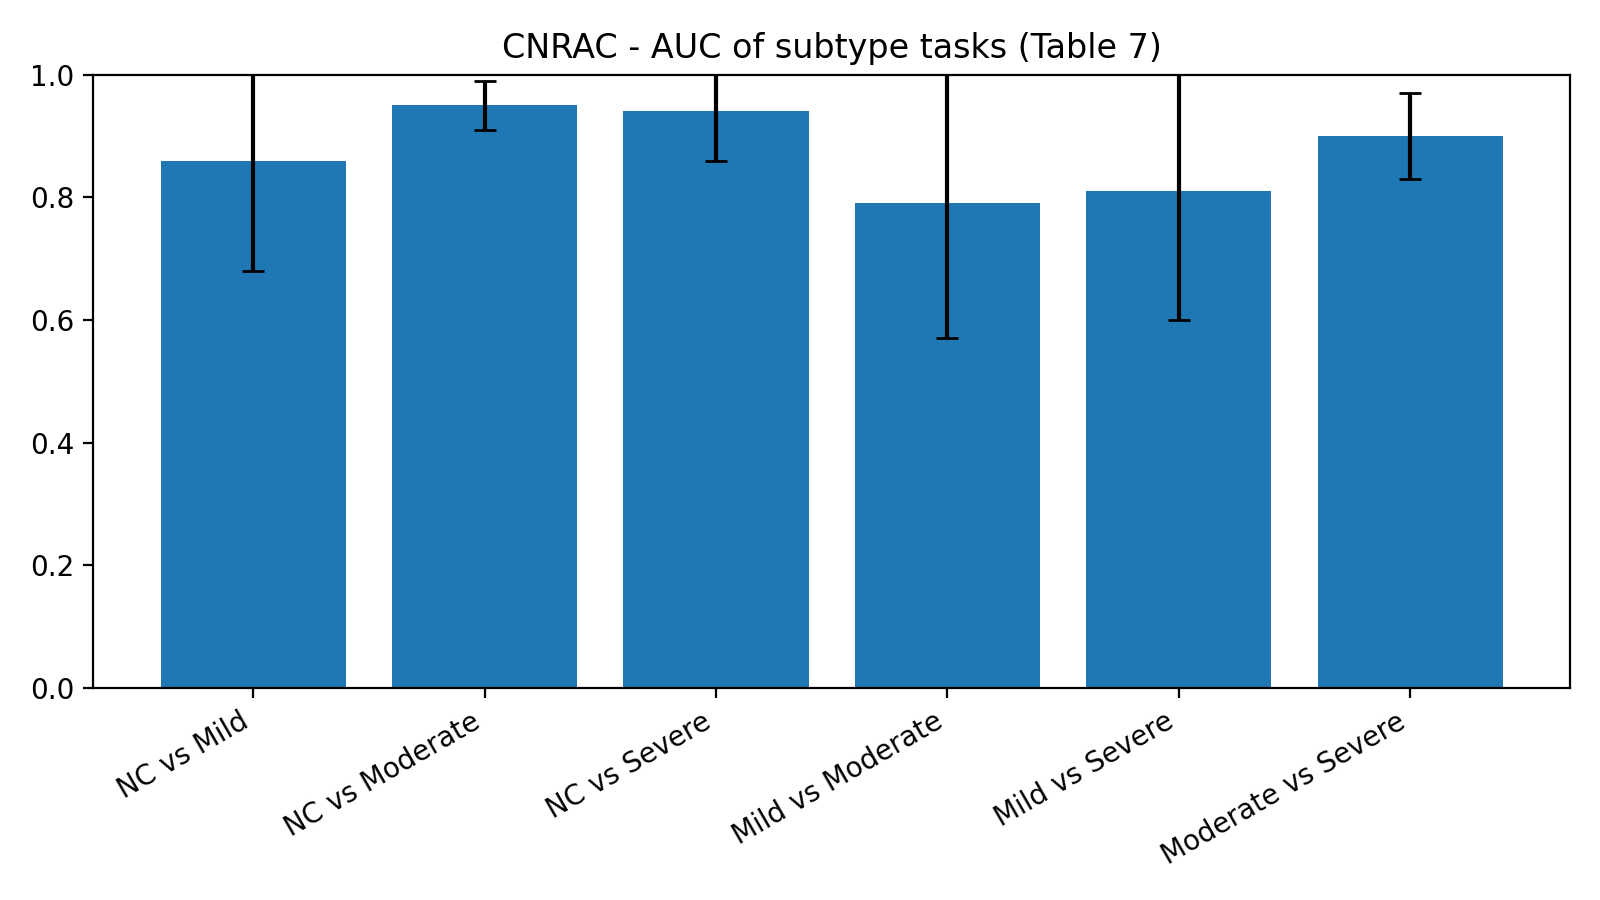
亚型任务:NC vs Moderate AUC 达 0.95

模型不仅能做"有没有抑郁",也能区分一定程度的严重度,但任务难度不一样。"NC vs Moderate" AUC 达到 0.95±0.04;而"Inter-Subtype(如 Mild vs Moderate)" AUC 为 0.79±0.22,标准差更大。语音线索对"健康与中重度差异"更敏感,相邻严重度之间差异更细微、模型更容易波动。
亚型 AUC
表 7:不同严重度对比的 AUC,NC vs Moderate 最高。
亚型 F1
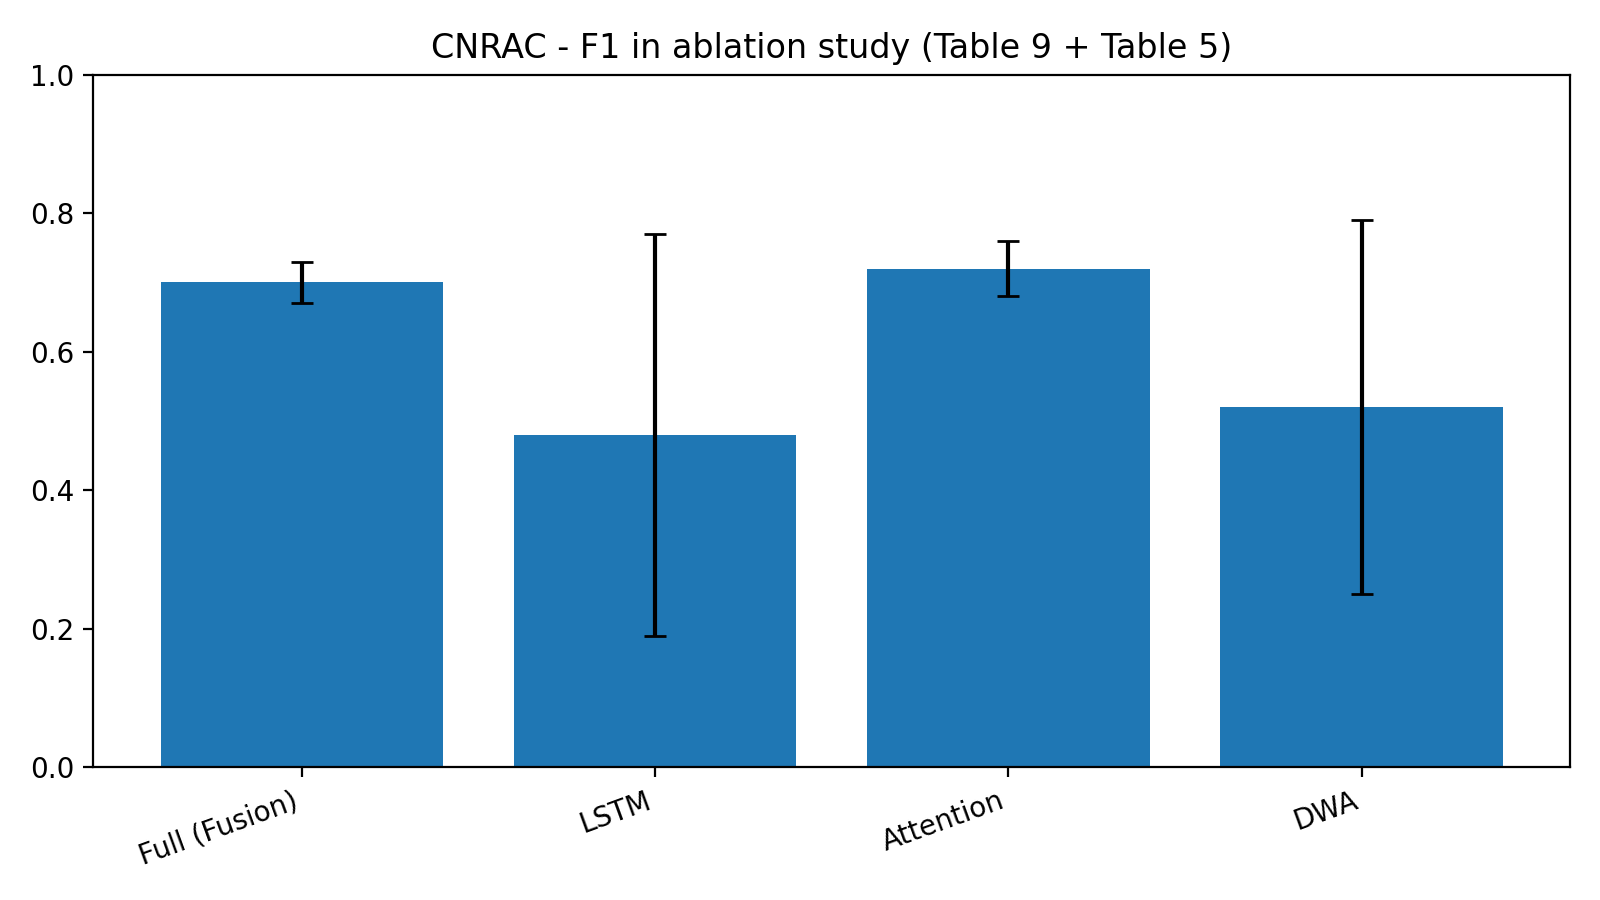
表 9:不同严重度对比的 F1 分数。

发现 3:关键模块与 Mel/MFCC 线索"确实起作用"

LSTM 与 DWA 是性能关键,87.5 % 显著特征指向 Mel/MFCC

消融实验:去掉 LSTM 后 ACC 从 0.81 降到 0.65,F1 从 0.70 降到 0.48;去掉 DWA 则 Precision 与 F1 降到约 0.5。在 HSFs 的统计检验中,32 个显著差异特征里 MFCC 相关占 43.75 %、Mel 谱相关占 43.75 %,合计 87.5 %。与人耳感知相关的 Mel/MFCC 线索是语音抑郁检测里更稳定的"信号来源"。

MFCC 相关
43.75 %
Mel 谱相关
43.75 %
其他
12.5 %

32 个显著差异 HSF 特征的类别占比

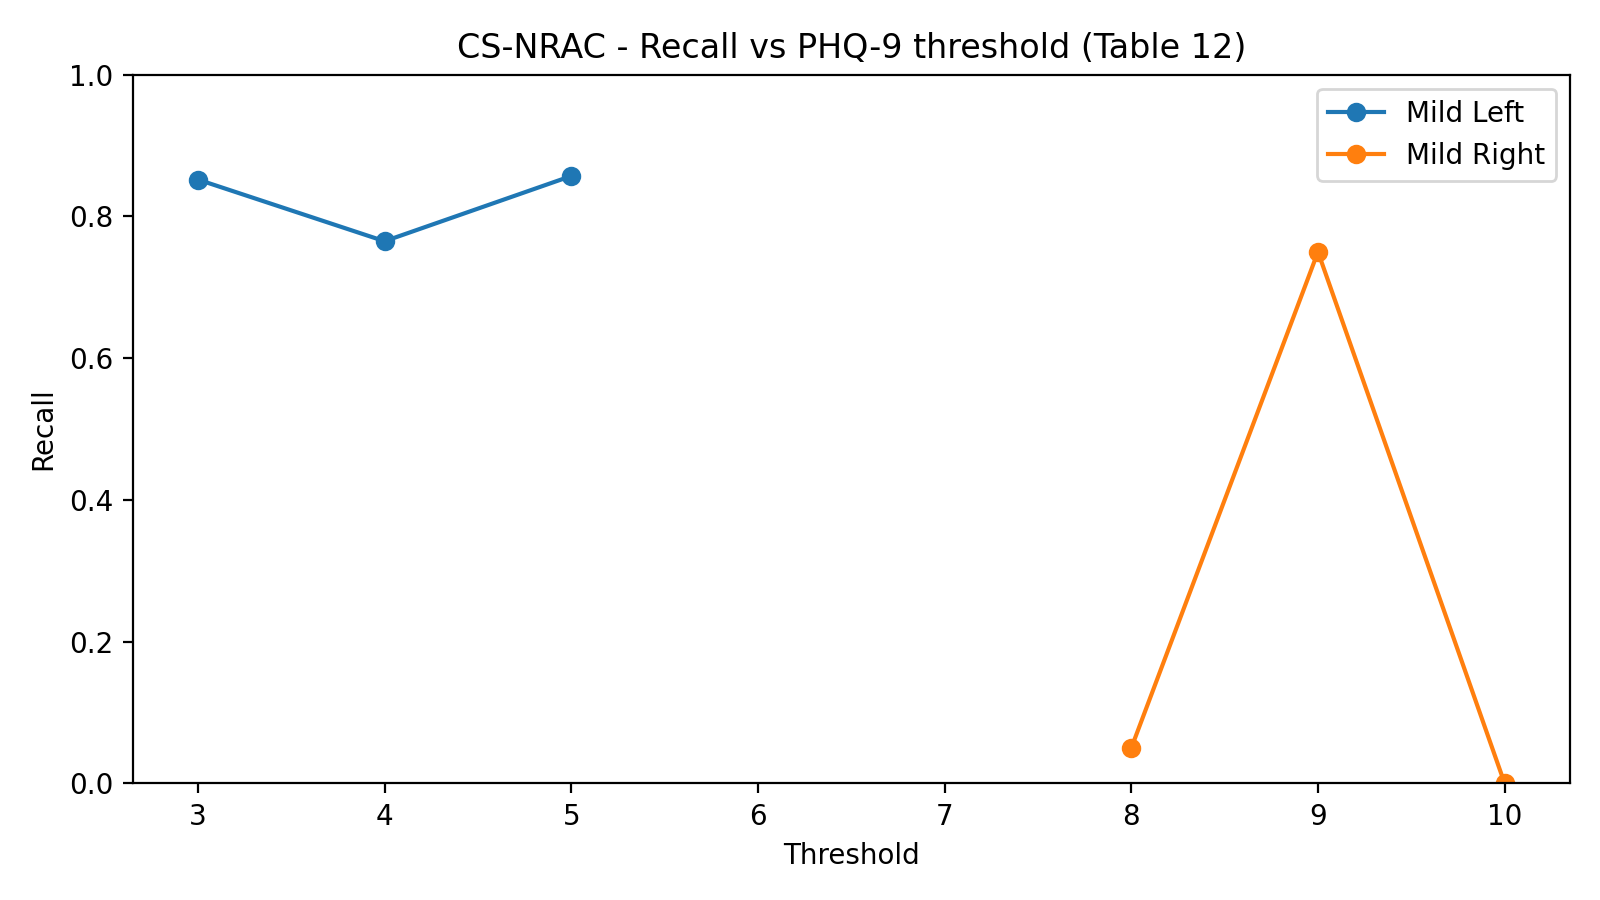
消融实验 Recall
表 12:消融实验——去掉各模块后 Recall 的变化。
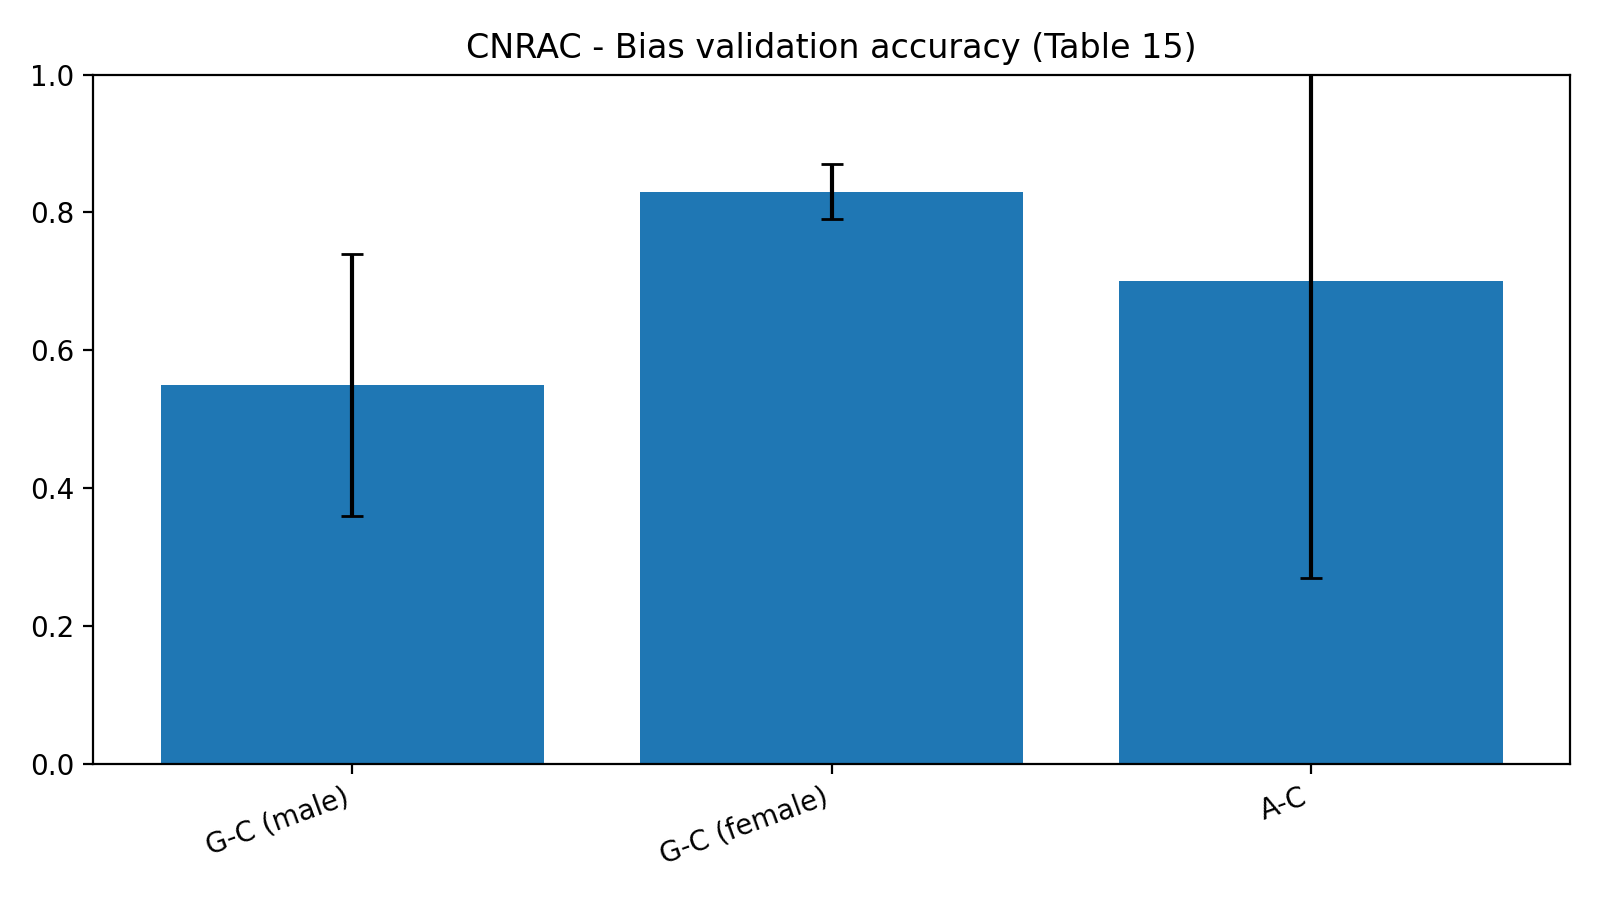
消融实验 Accuracy
表 15:消融实验——去掉各模块后 Accuracy 的变化。
评估指标

如何衡量"AI 听得准不准"?

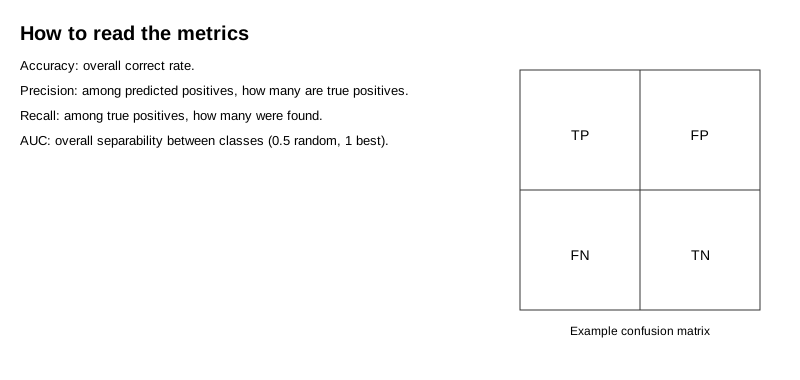
指标说明
ACC(准确率)、AUC(区分能力)、F1(精确率与召回率的调和)——三个维度共同描述模型的实用水平。
应用前景

这项研究有什么用?

✓

证据支持

在 CNRAC 上,融合模型优于多种对比深度模型;迁移验证 ACC 0.89±0.02、F1 0.89±0.03

?

合理推测

结合标准化录音流程,ABAFnet 可能用于大规模筛查的初筛环节,但需更多多中心数据与真实流程验证

局限与展望

需要注意的边界

外部验证受限:CS-NRAC 中抑郁样本较少,PHQ-9 阈值划分本身存在可靠性讨论。

训练耗时更长:需提取并处理四类特征,比端到端模型训练耗时更长。

人群差异仍需关注:不同性别/年龄子群的 Accuracy 存在差异,需更均衡数据验证。

🎙️

一句话带走:多特征融合,让语音抑郁检测更稳。

常见问题

FAQ

"只要说话就能诊断抑郁"吗?
不是。论文是在特定录音与朗读任务下的机器学习分类实验,CS-NRAC 部分也强调 PHQ-9 只是筛查工具而非临床诊断。
我能用它做自测吗?
论文未提供可用于个人自测的产品或阈值,也未报告家庭/手机随录场景的可靠性。抑郁评估需要专业人士综合判断。
为什么要用 4 种特征?
融合模型 AUC 0.85±0.04 高于最佳单一特征 Mel-spectrogram 的 0.80±0.03。单一特征可能忽略语音的多层次信息。
哪种特征最关键?
去掉 Mel-spectrogram 带来最大性能下降;在 HSFs 解释性分析里,MFCC 与 Mel 谱相关特征合计占 87.5 %。
"NC vs Mild"精确度很低,是不是模型不行?
Precision 均值 0.25±0.27 表明该任务更难或数据分布不稳定;样本不平衡需随机下采样,细微差异更难区分。
模型在不同性别/年龄上公平吗?
补充实验显示不同组的 Accuracy 不同,仍需更均衡数据验证。
会不会侵犯隐私?
两套数据均取得知情同意并通过伦理审批(附伦理批号);但若落地真实产品仍需额外隐私保护与合规设计。
代码或数据在哪里?
论文提供了代码仓库地址,语音统计特征可在合理请求下获取。
术语词典

公众版小词典

VAD
语音活动检测——自动找到"有人说话"的片段并剪掉静音/噪声
声谱图
"时间×频率"的热力图,把音乐变成随时间变化的"指纹图"
Mel 声谱图
声谱图的"人耳版"频率刻度,更贴近人类听觉
MFCC
从 Mel 谱提取的压缩表征,像把复杂图案压缩成一串数字
OpenSMILE
开源语音特征提取工具箱,一次能输出大量指标
LSTM
擅长处理序列数据的神经网络,能"记住前文剧情"
注意力机制
让模型自动更关注关键片段,像用荧光笔标出重点
AUC
衡量模型区分两类的整体能力,0.5 ≈ 随机、1 ≈ 完美

本页面仅用于科研科普与方法解读,不构成医疗建议或诊断依据。若你或身边的人正在经历情绪困扰,请及时联系专业医疗机构或心理健康服务。