一个人说话的方式,可能藏着情绪的线索。这项研究用四种声音特征训练AI,让它像"多位医生会诊"一样综合判断——准确率超过 81%。
你有没有注意过:当一个人心情低落时,说话的语调、节奏甚至音量都会和平时不太一样?有时候不用听内容,光凭"声音的感觉"就能隐约察觉到对方的状态。
那么问题来了:如果人类凭感觉就能"听出"情绪变化,AI 能不能做得更准确?
这项研究的答案是:可以,但不能只听一种线索。研究者从同一段录音里提取了 4 类不同的声学特征(相当于请了4位"专家"分别从不同角度打分),再用注意力机制把这些分数智能地加权汇总。
抑郁症是全球最常见的精神健康问题之一。COVID-19 之后,发病率更是明显上升。但目前的诊断和评估主要依赖医生访谈 + 量表打分,这种方式需要专业人员面对面操作,耗时长、主观性强,而且很难大规模筛查。
与此同时,声音是一种非常容易获取、完全无创的数据。你只需要说几句话,录音就包含了丰富的信息:语速快慢、音调高低、能量变化、音色特点……这些特征在抑郁人群和健康人群之间往往存在细微但系统性的差异。
但之前的研究有一个共同的不足:大多只用了一种声学特征来做判断。就好比你去看病,只量了体温就下结论——显然不够全面。这项研究的核心创新就是:把 4 种不同维度的声音特征"联合会诊"。
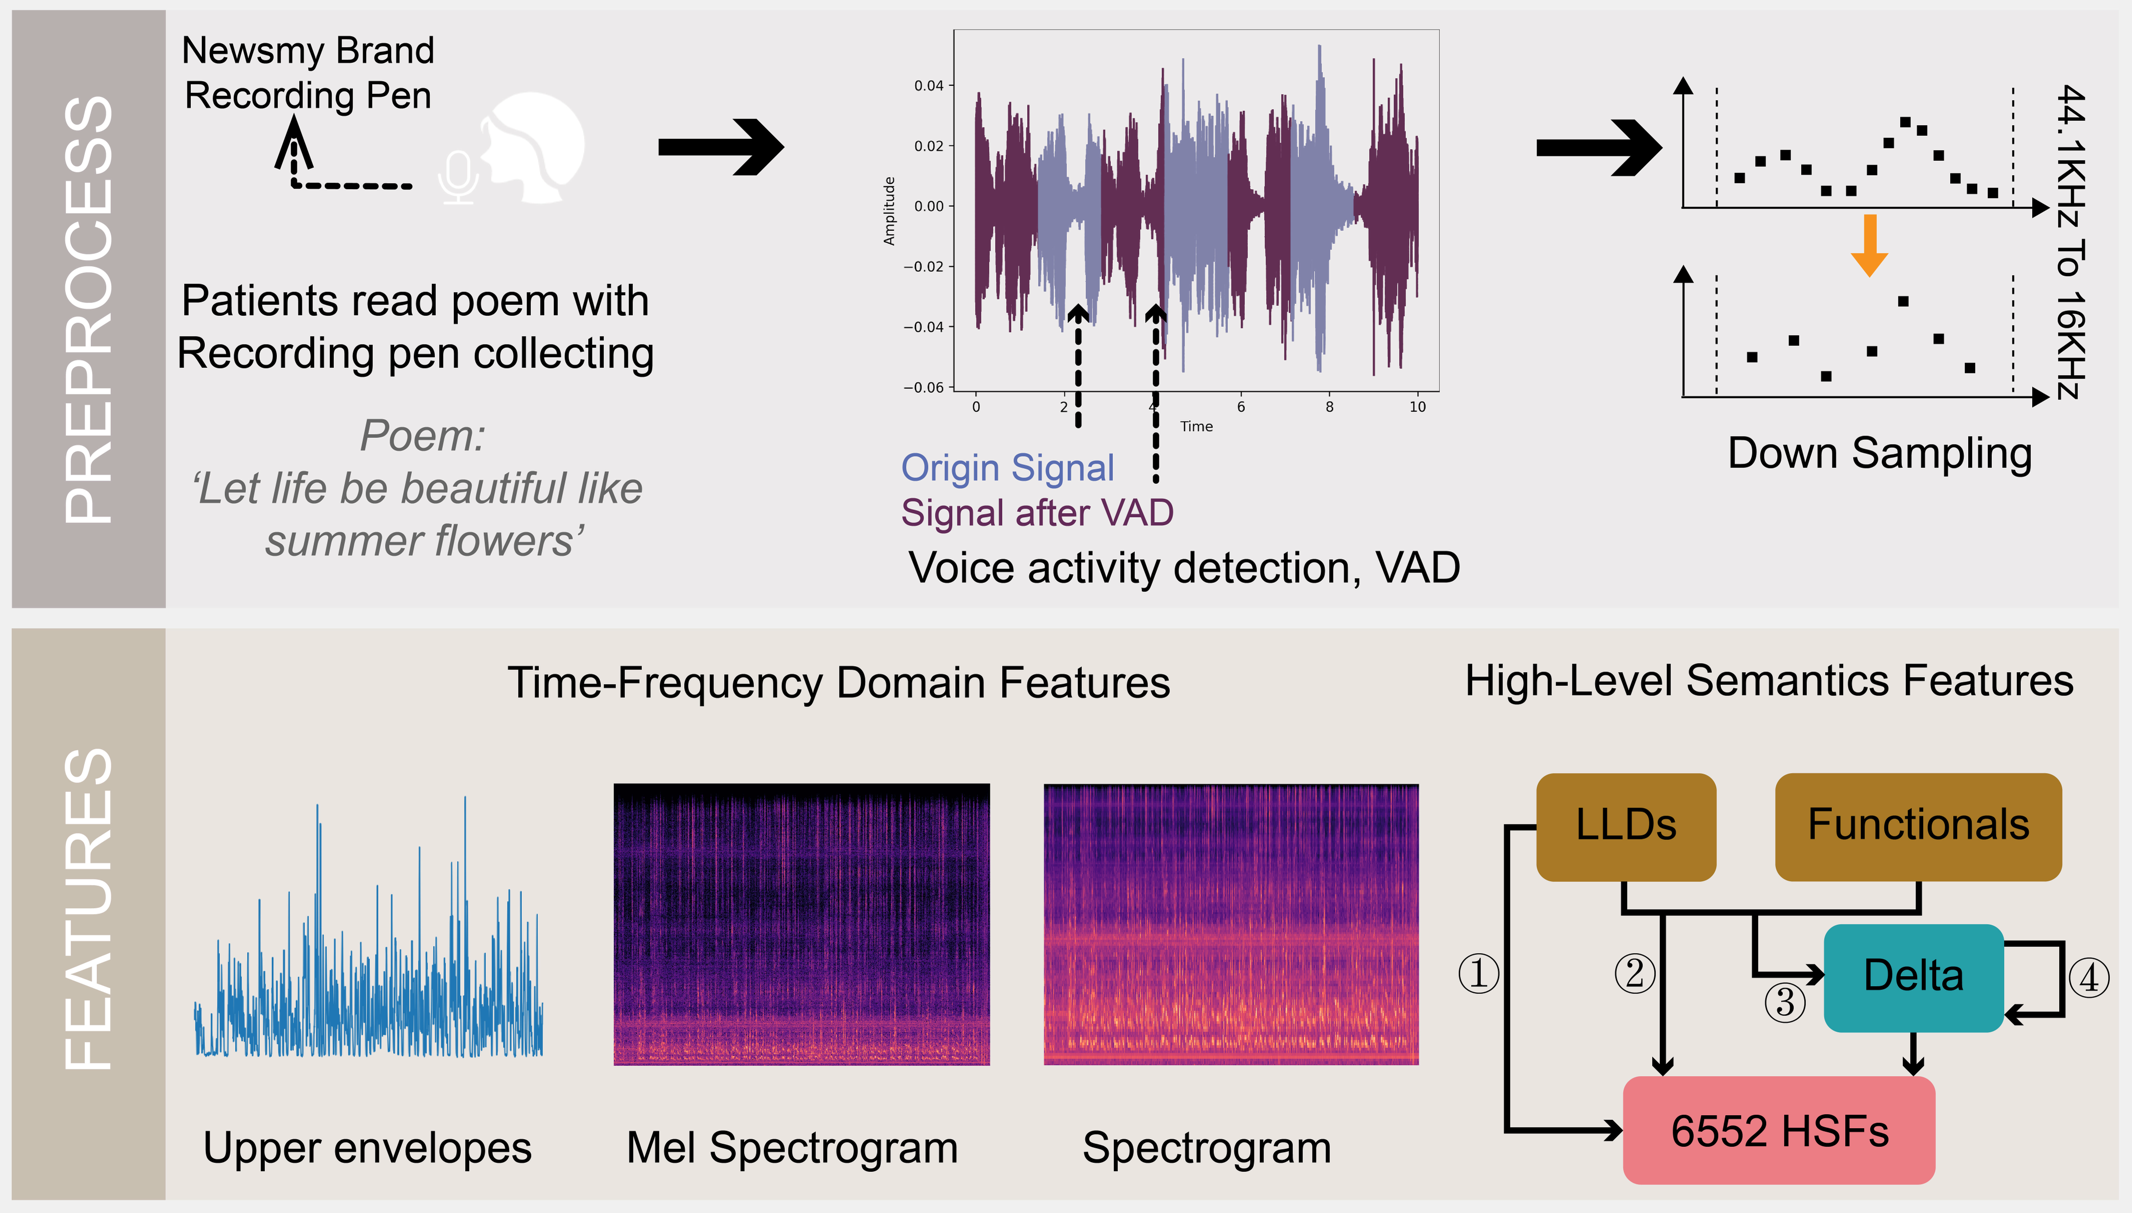
受试者朗读固定文本,去掉静音段,统一采样率为 16kHz
→从同一段录音中提取上包络、频谱图、梅尔谱和 HSFs
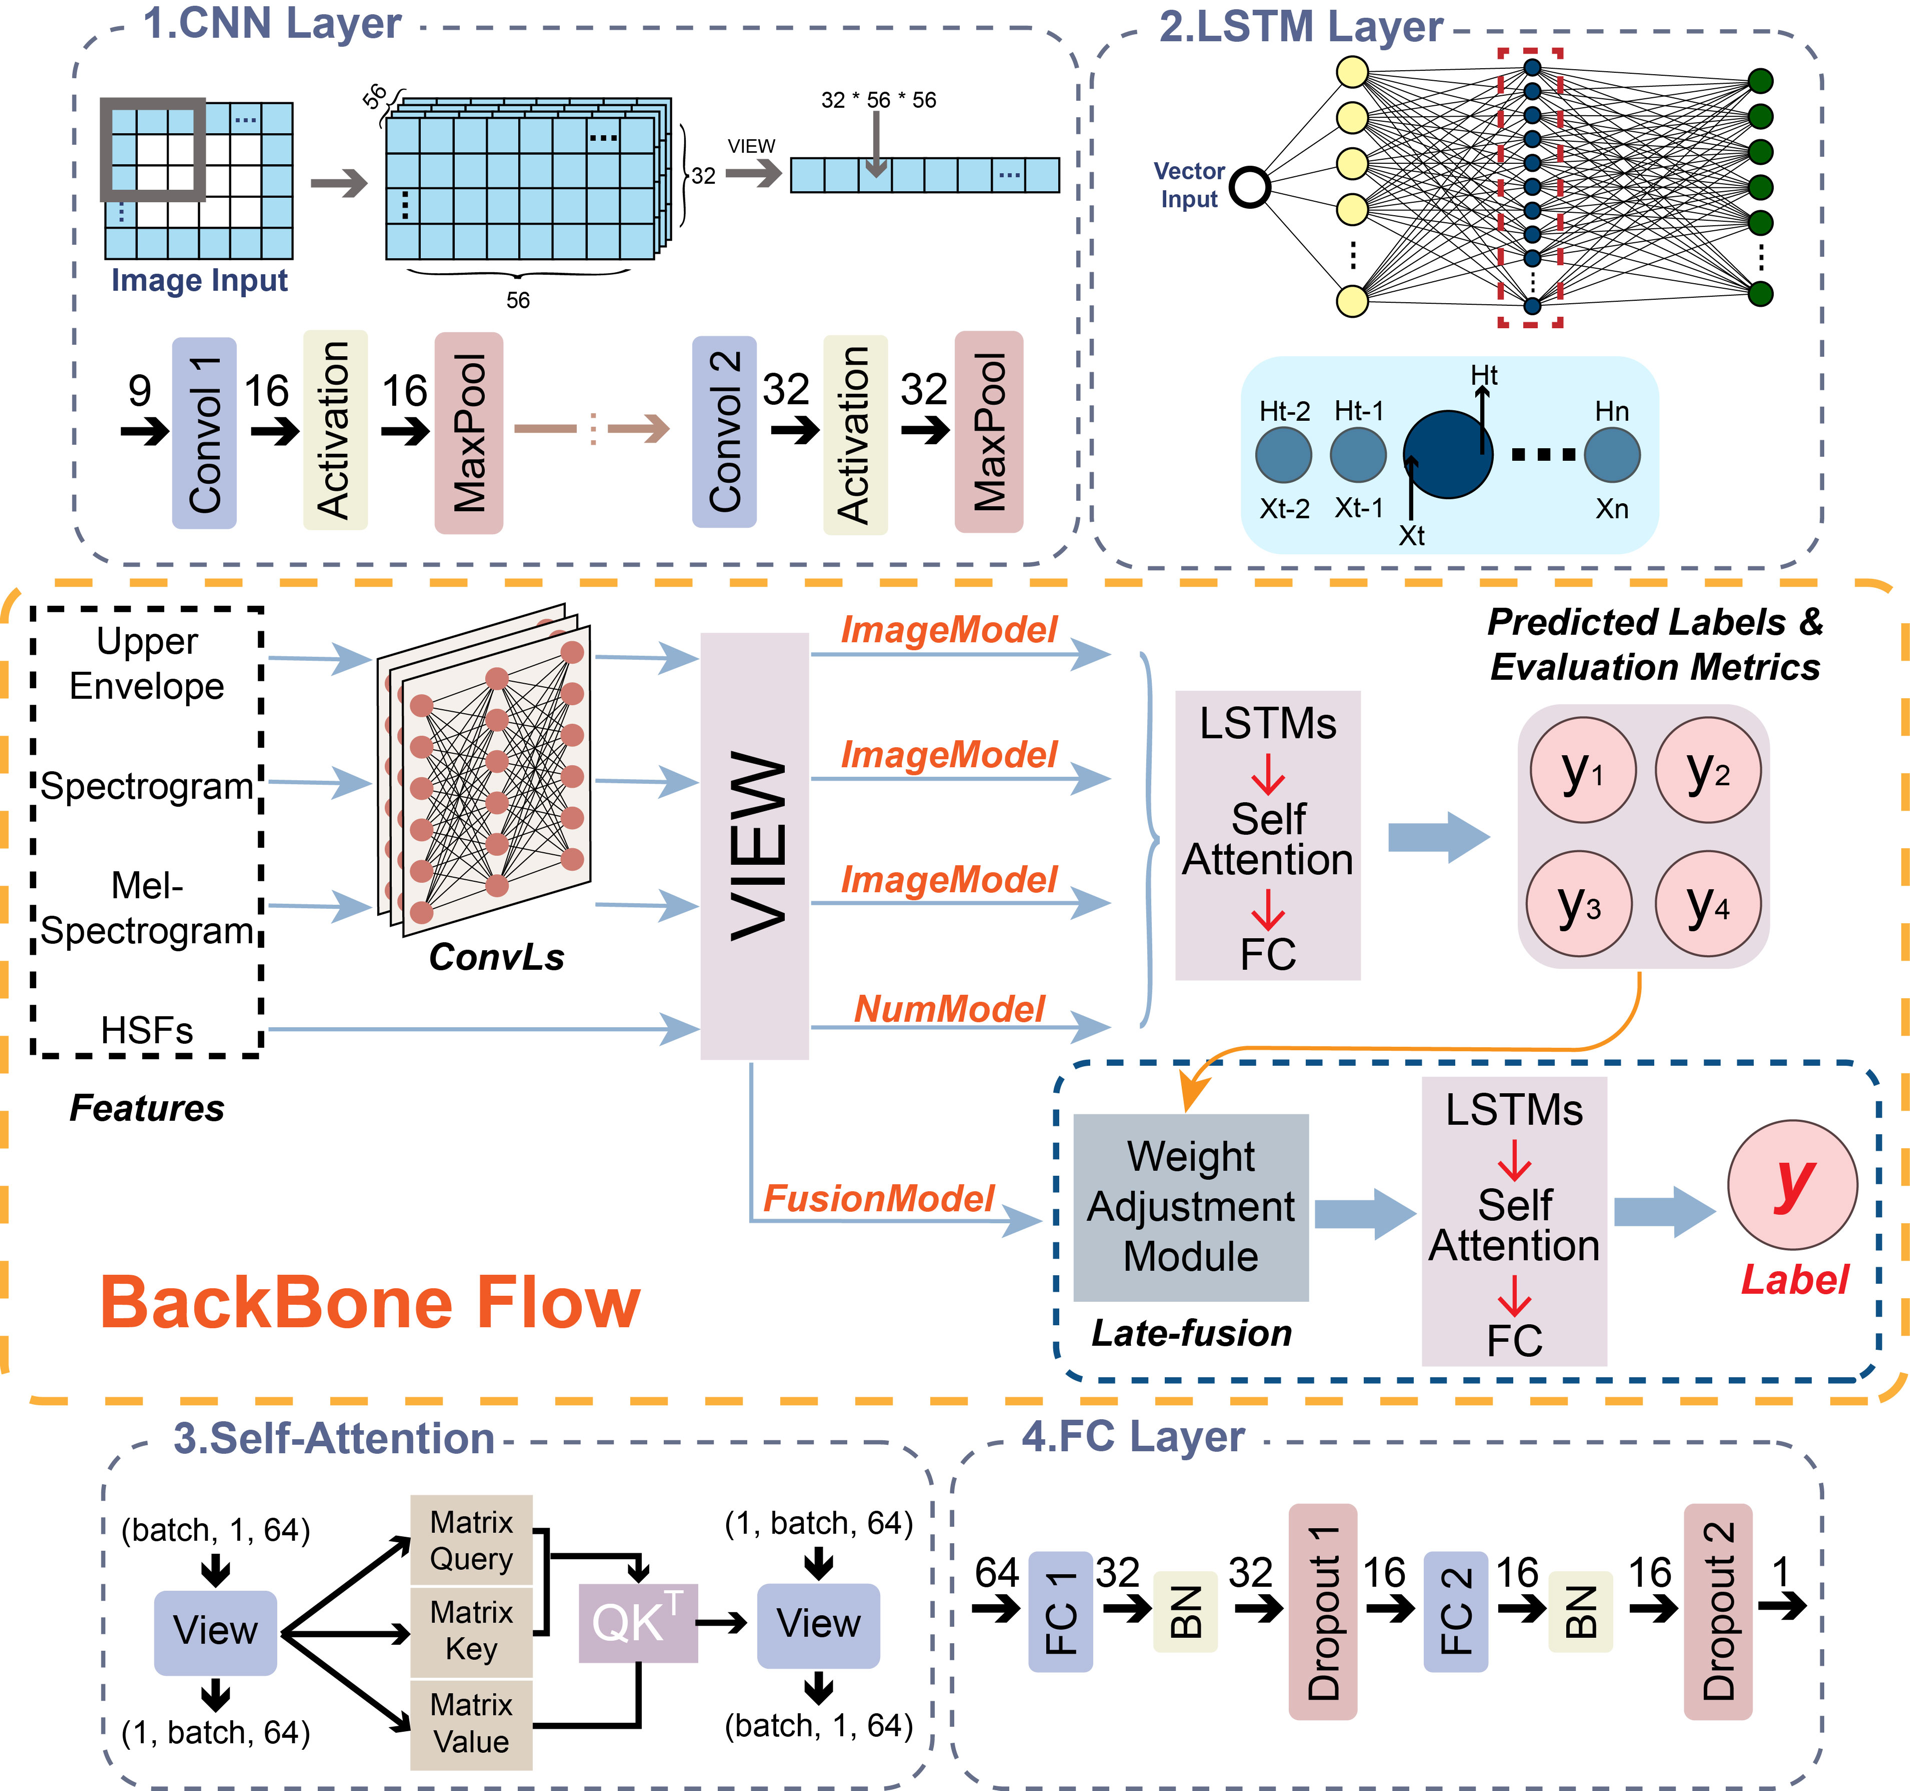
→每类特征用 CNN+LSTM+注意力各训练一个"专家"模型
→按各专家表现分配权重,汇总得出最终判断
同一段录音,从 4 个不同角度"翻译"成 AI 能理解的信号。就像同一幅风景,用不同镜头拍出来的效果完全不同:
描绘声音波形的"峰值轮廓",反映说话时能量的起伏节奏。就像从远处看山脉的天际线——只看大轮廓,忽略细节。
把声音按频率拆开,画成随时间变化的"热力图"。就像用棱镜把白光分成彩虹——看每个频率的能量分布。
和频谱图类似,但用更接近人耳听觉的刻度来表示频率。人耳对低频更敏感,梅尔谱就反映了这种"听觉偏好"。
用专业工具 OpenSMILE 从底层指标中汇总出 6552 维的"体检报表"——涵盖能量、音调、节奏等多维统计信息。
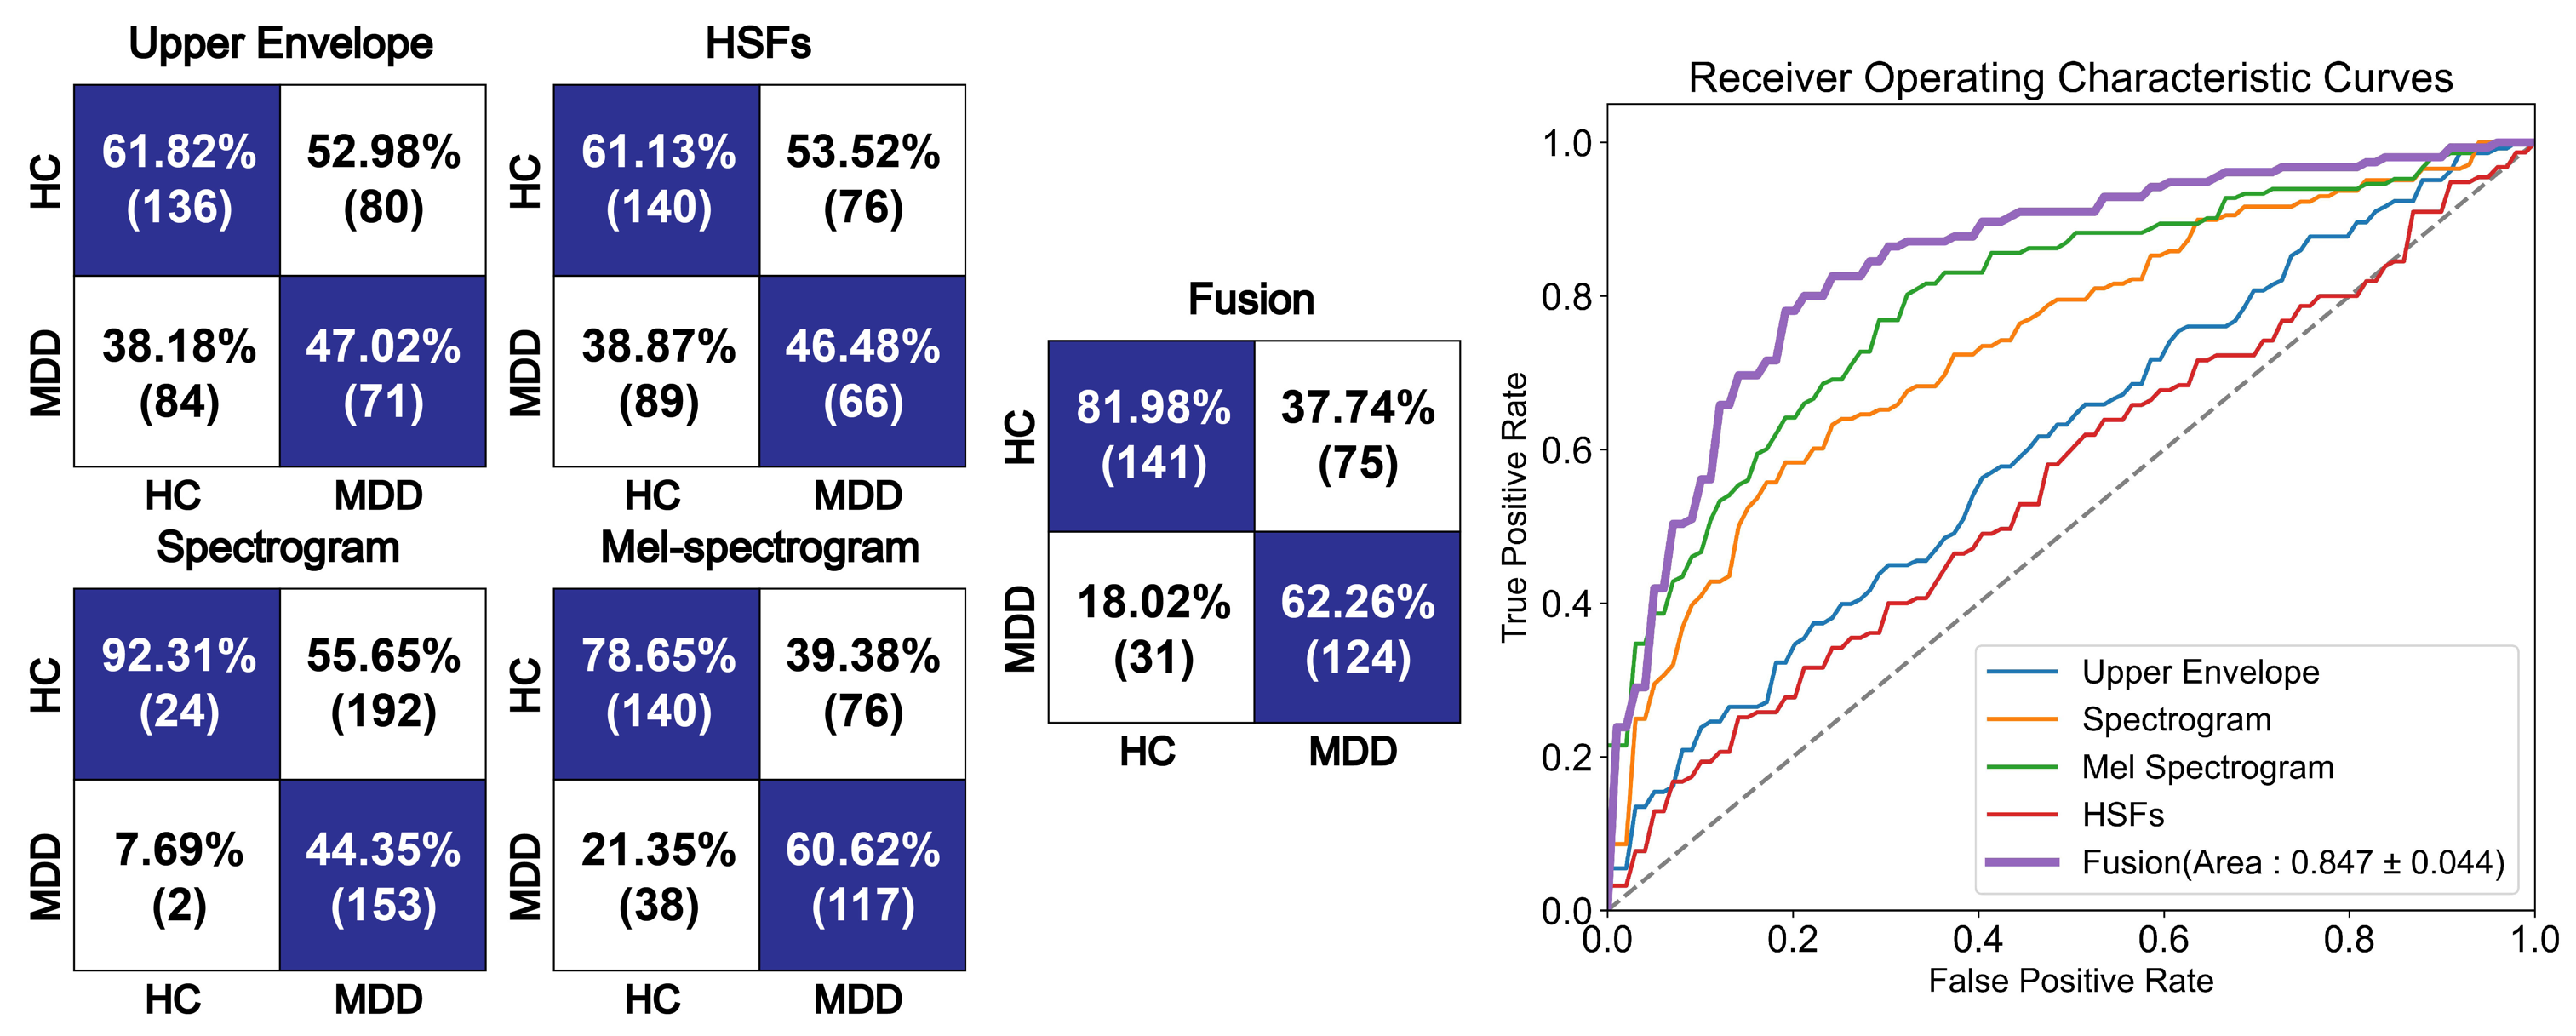
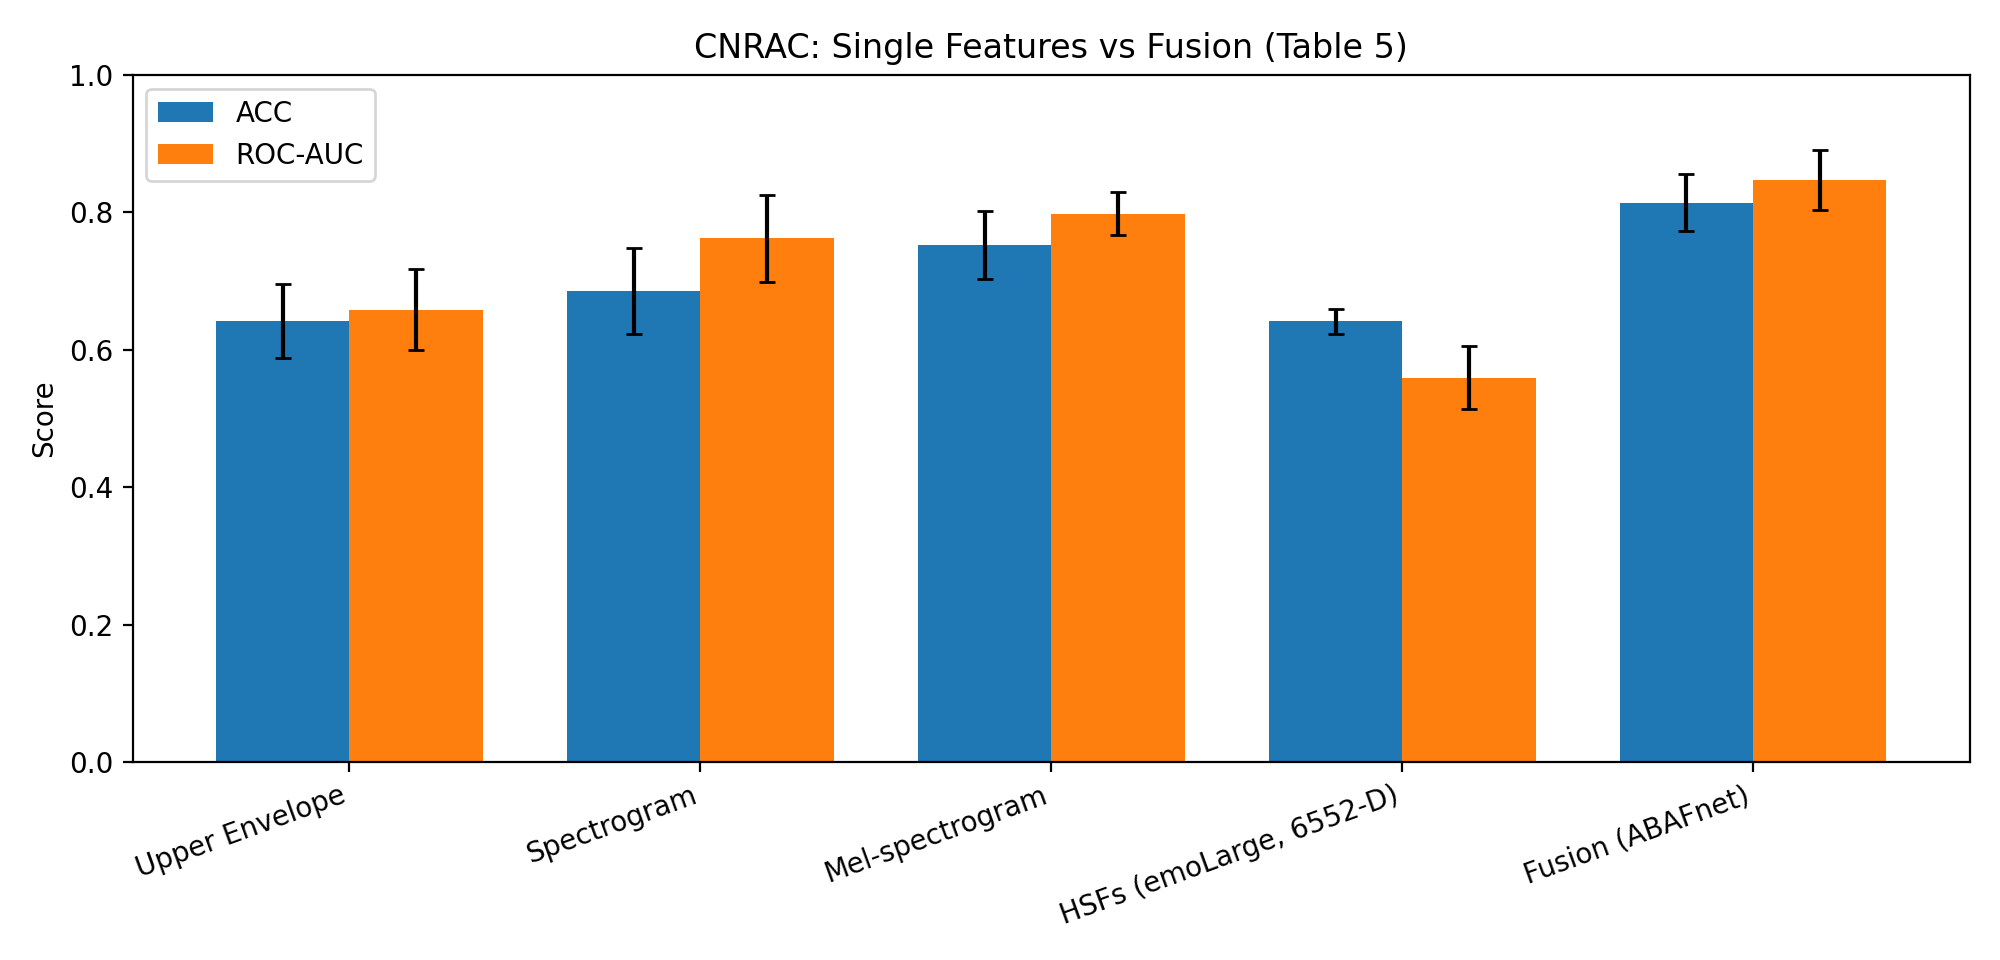
在临床数据集 CNRAC 上,融合模型的准确率达到 81.4%,而表现最好的单特征(梅尔谱)只有 75.2%。ROC-AUC 从 0.798 提升到 0.847。
这意味着抑郁相关的声音线索分散在多个维度——有些反映在能量起伏中,有些藏在频率结构里。只盯一个维度,必然会"看漏"。
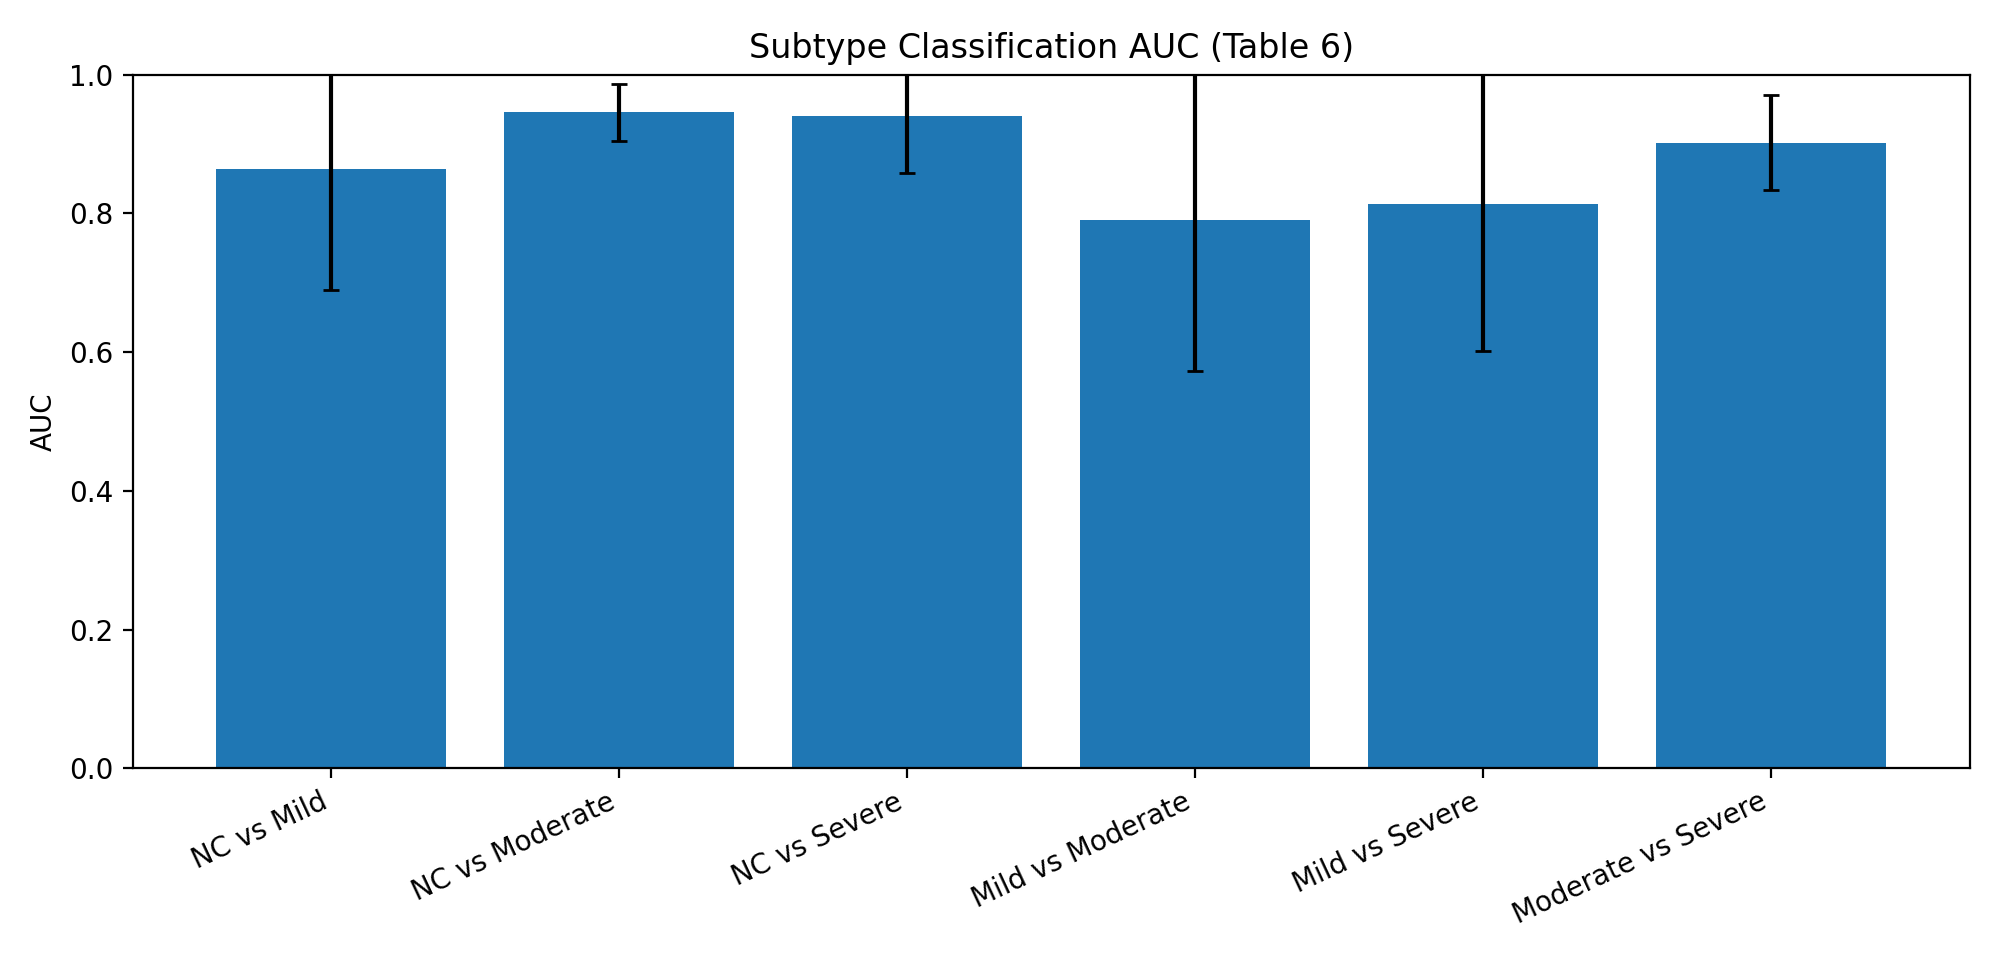
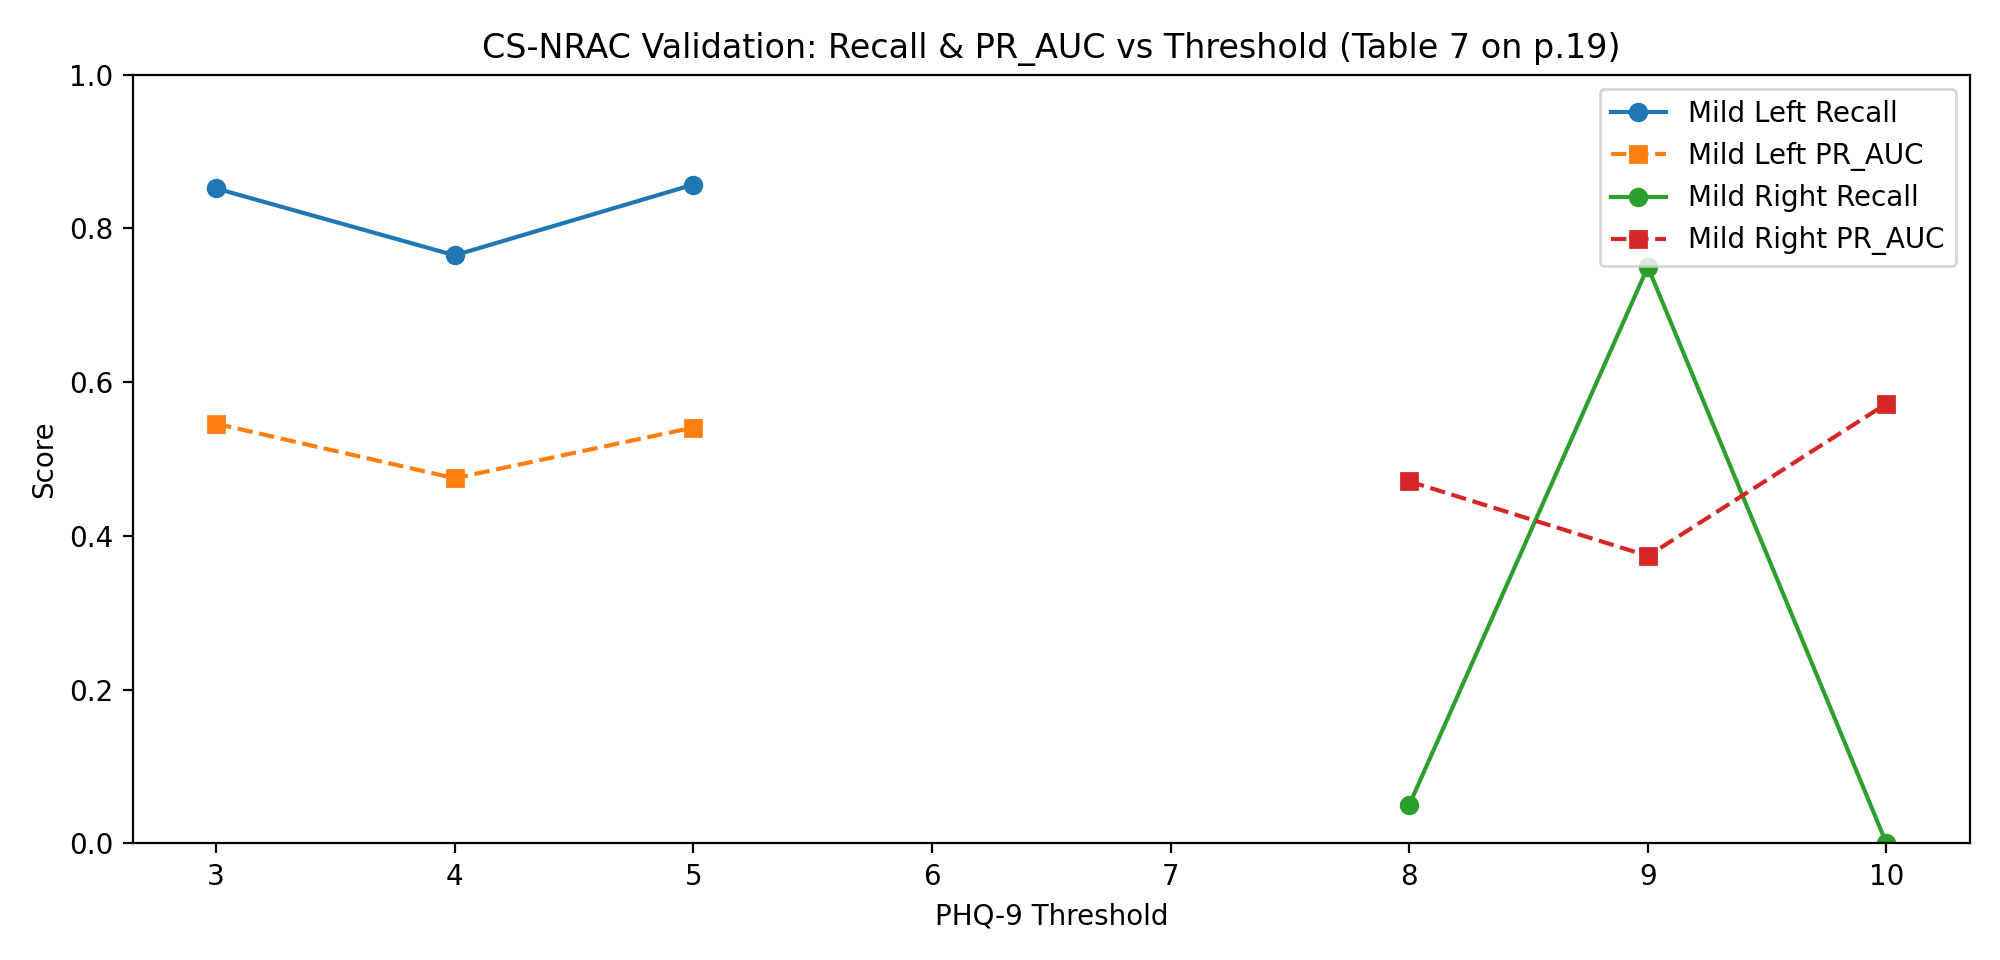
研究还测试了模型在抑郁严重度分级上的表现(正常 vs 轻度/中度/重度的两两对比)。其中:
这说明模型不只能做"有/无"的二分类,对严重度差异也有一定区分能力。不过需要注意:轻度样本量较少(仅 13 例),结论需谨慎。
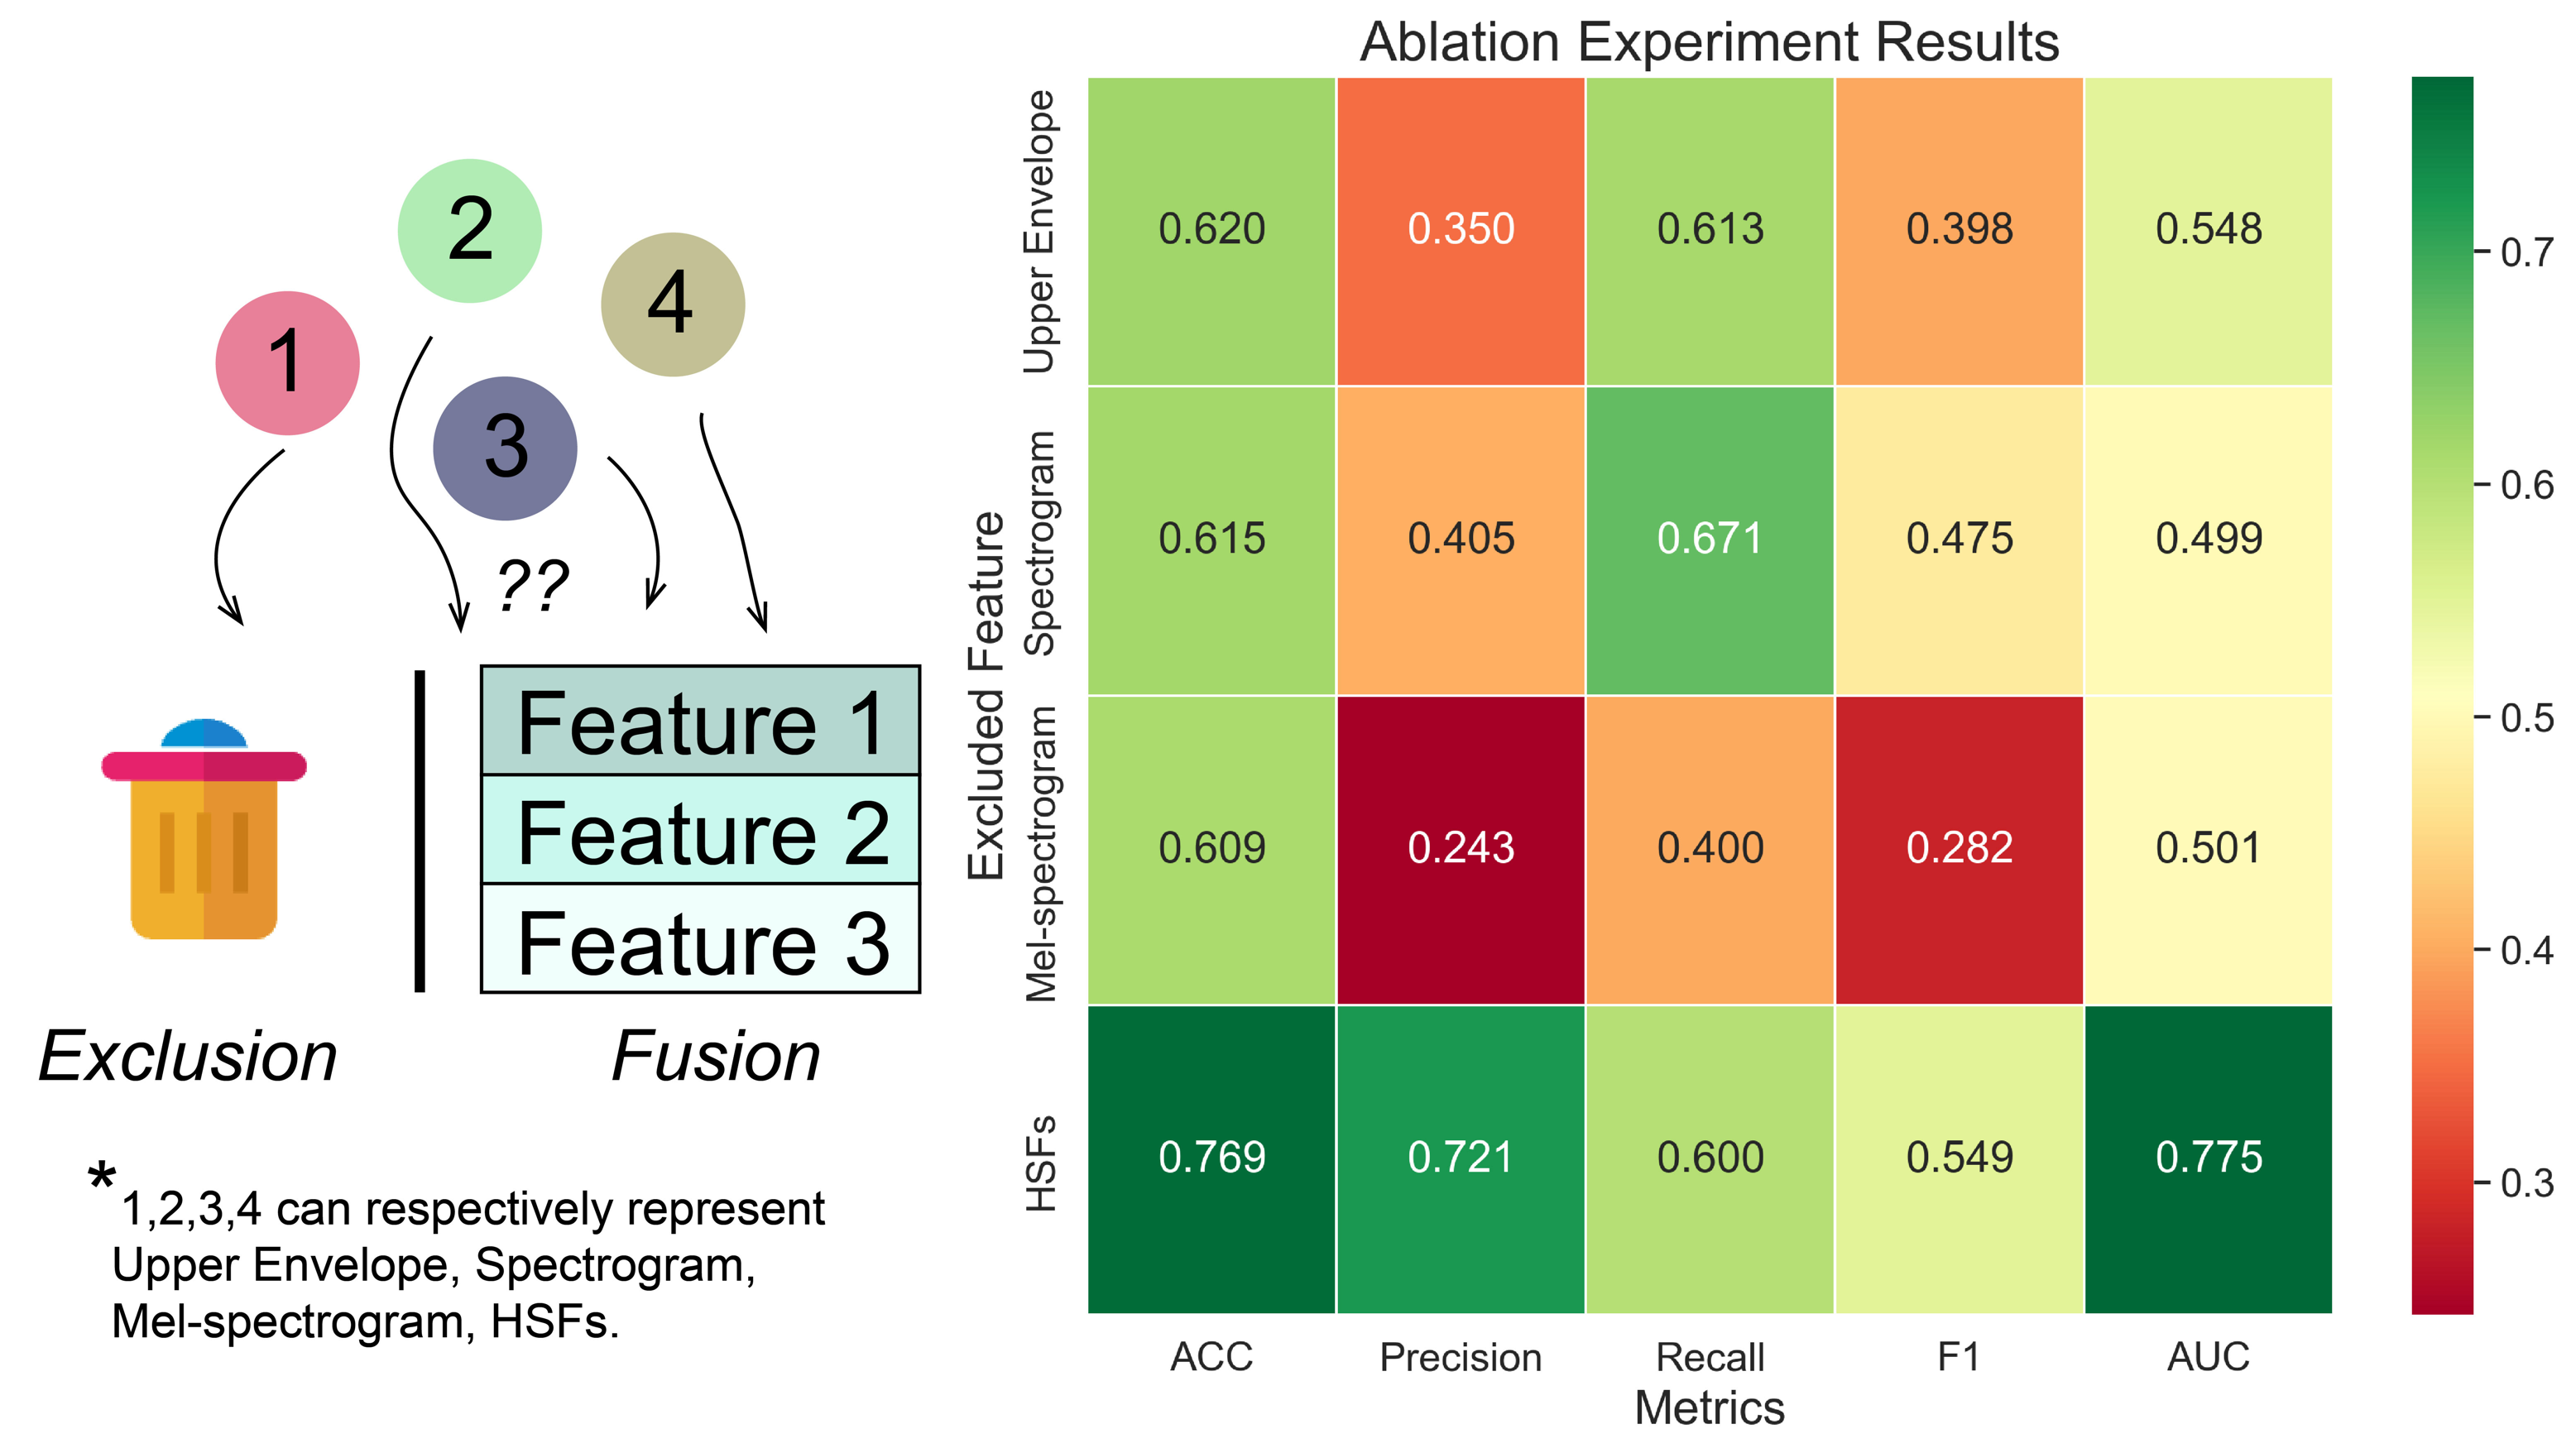
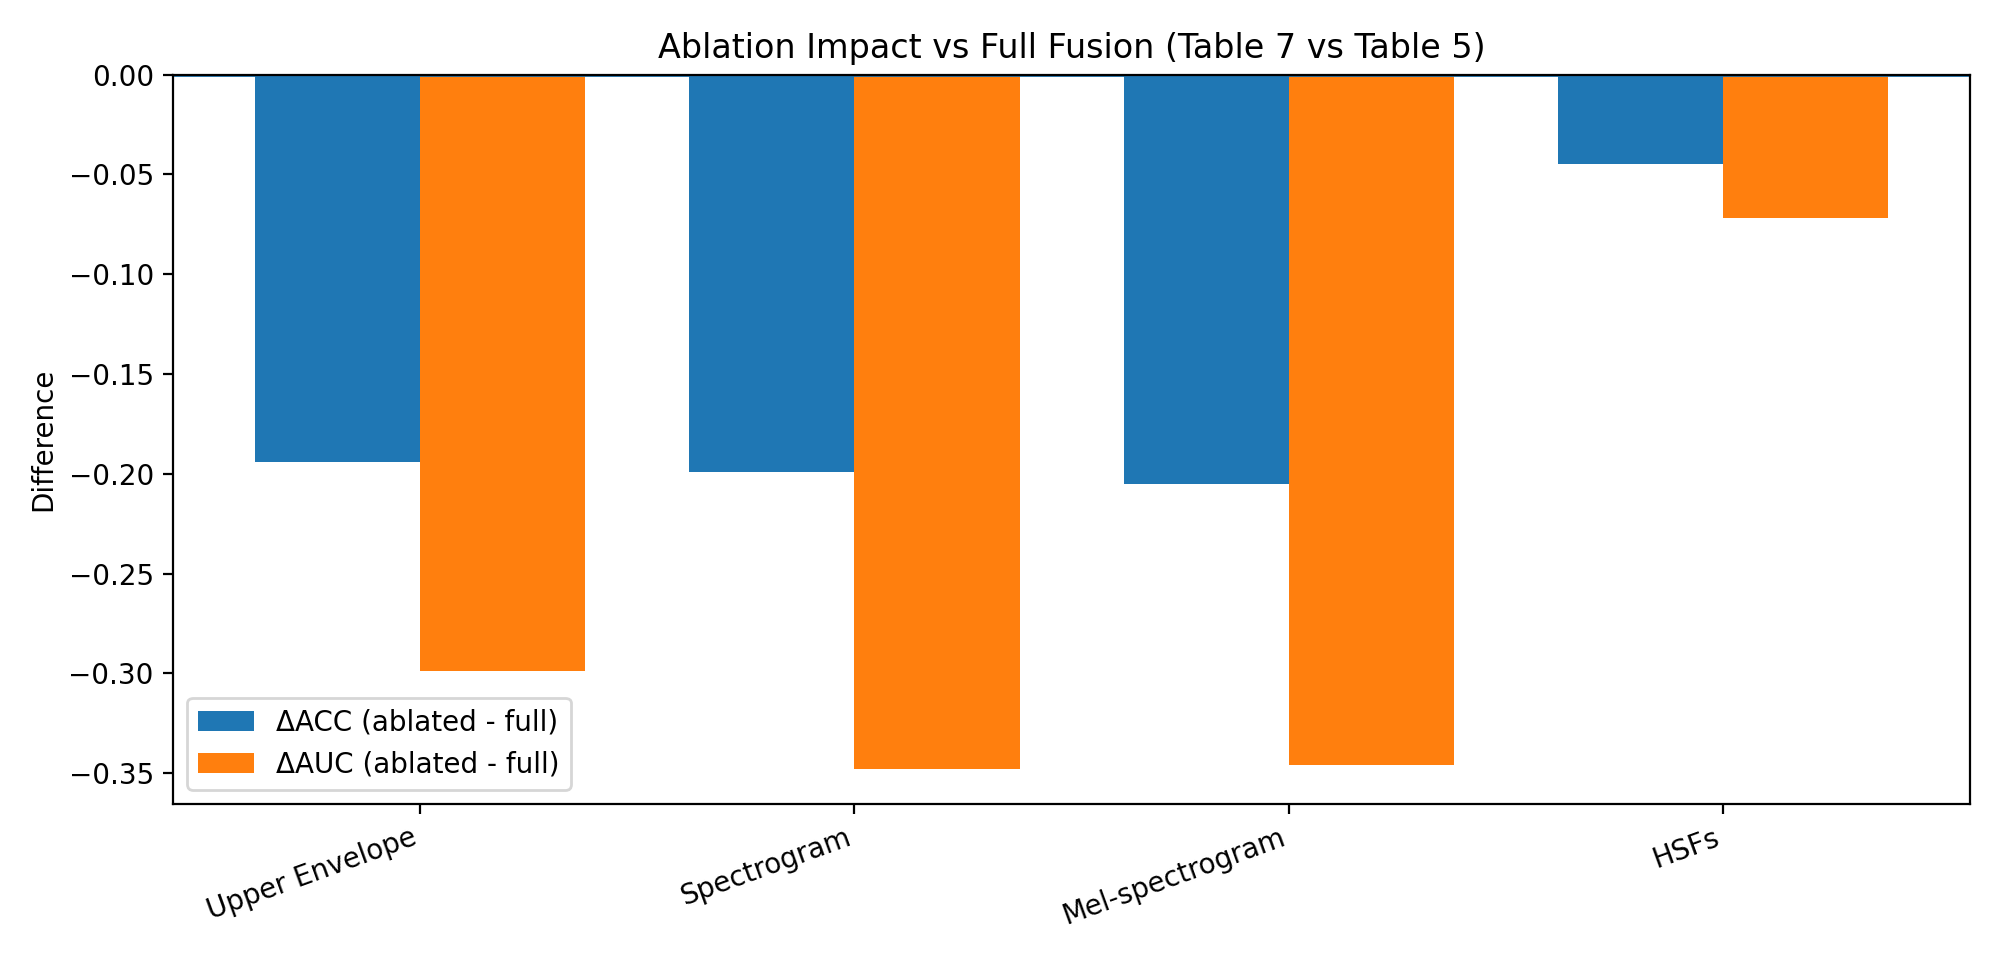
消融实验(逐个去掉某类特征看性能变化)显示:去掉梅尔谱时准确率下降最严重(从 81.4% 降到 60.9%),说明它是信息量最大的单一特征。
但值得注意的是:去掉任何一种特征都会导致性能下降,说明 4 种特征各自提供了不可替代的信息,真正的优势来自"互补"。
简单说:这项研究证明了"用声音辅助检测抑郁"的技术路线是可行的,而且多特征融合是提升准确性的关键。但距离"拿起手机就能自测"还有很远的路——需要在更多环境、更多人群中反复验证,并妥善处理隐私和误判风险。
单特征 vs 融合模型的准确率和 AUC 对比
消融实验 — 去掉每类特征后性能下降幅度
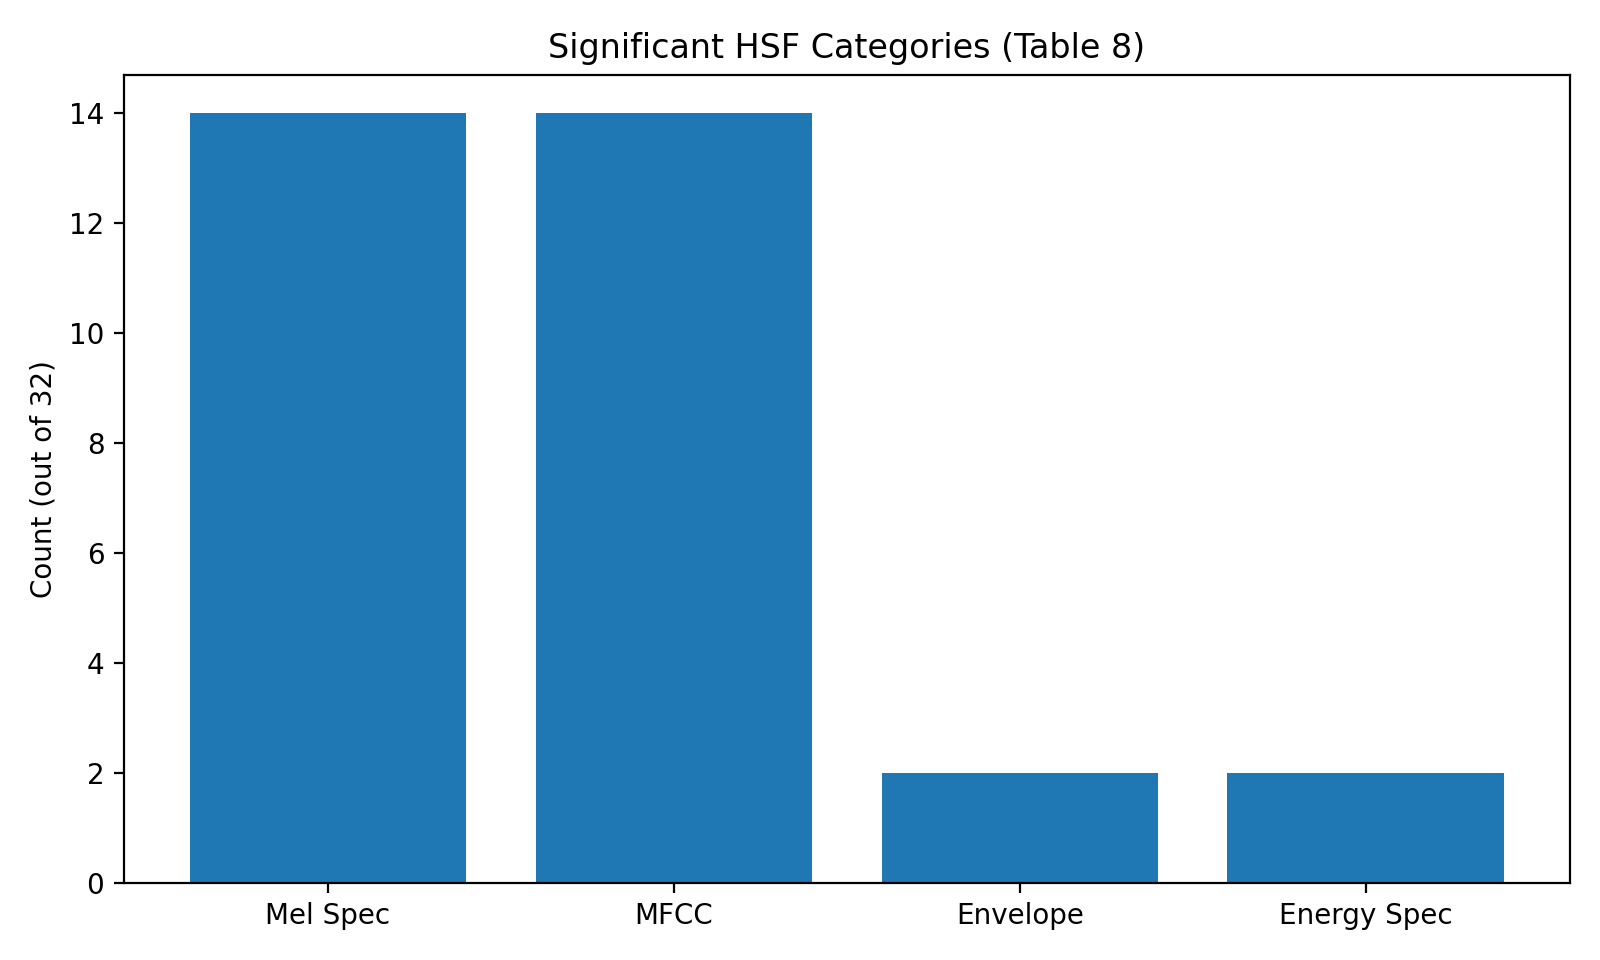
32 个显著差异特征中,MFCC 和梅尔谱占比 87.5%
大规模筛查数据在不同阈值下的表现
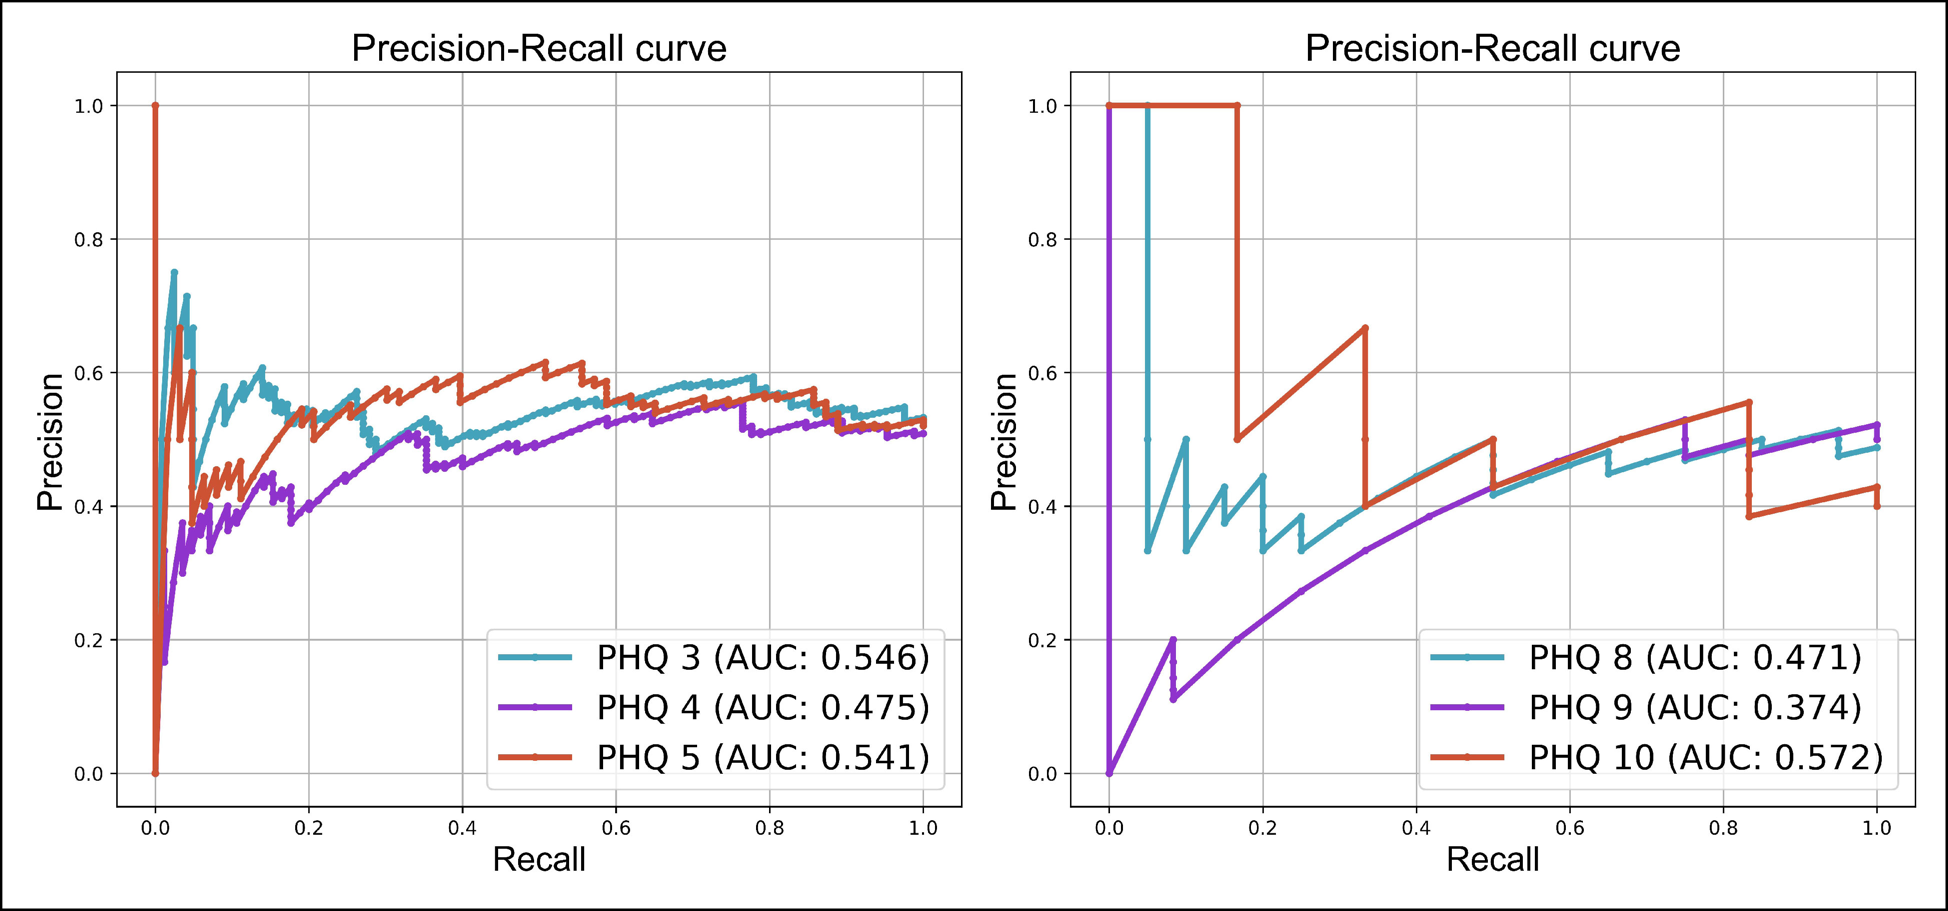
PR 曲线 — 在类别不均衡场景下的评估
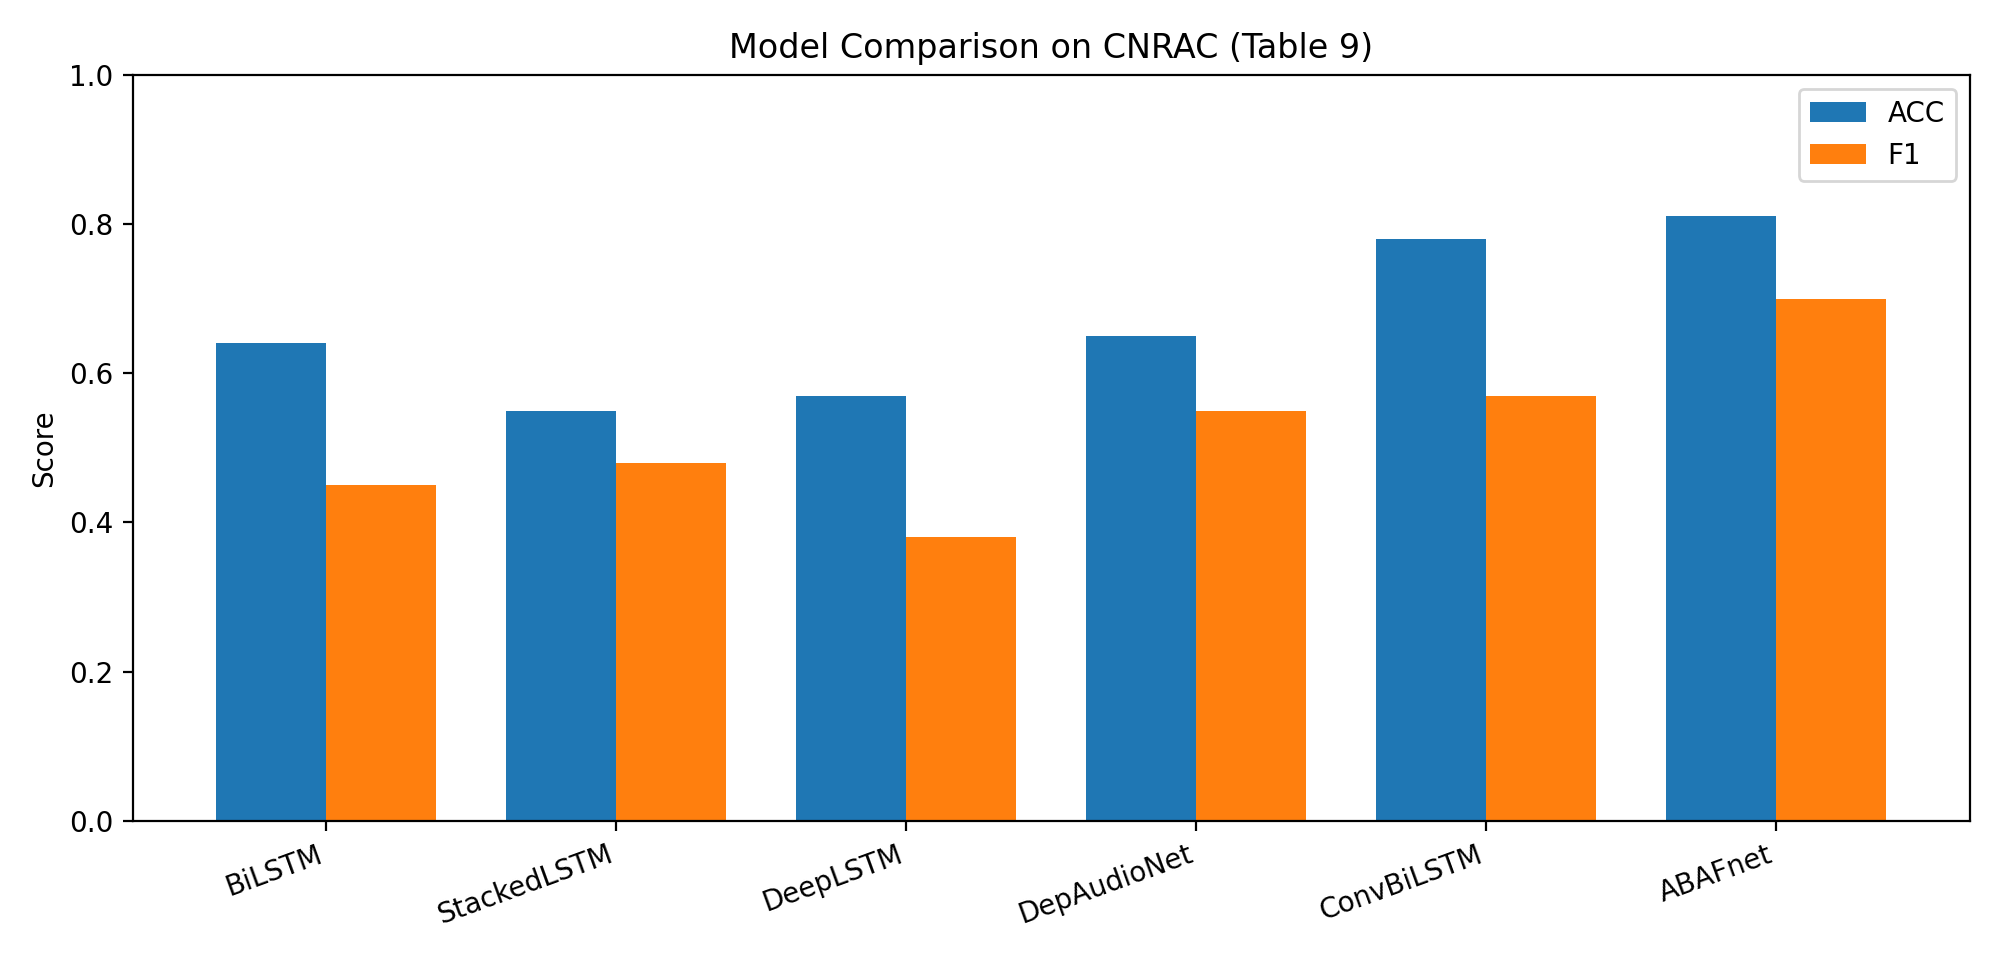
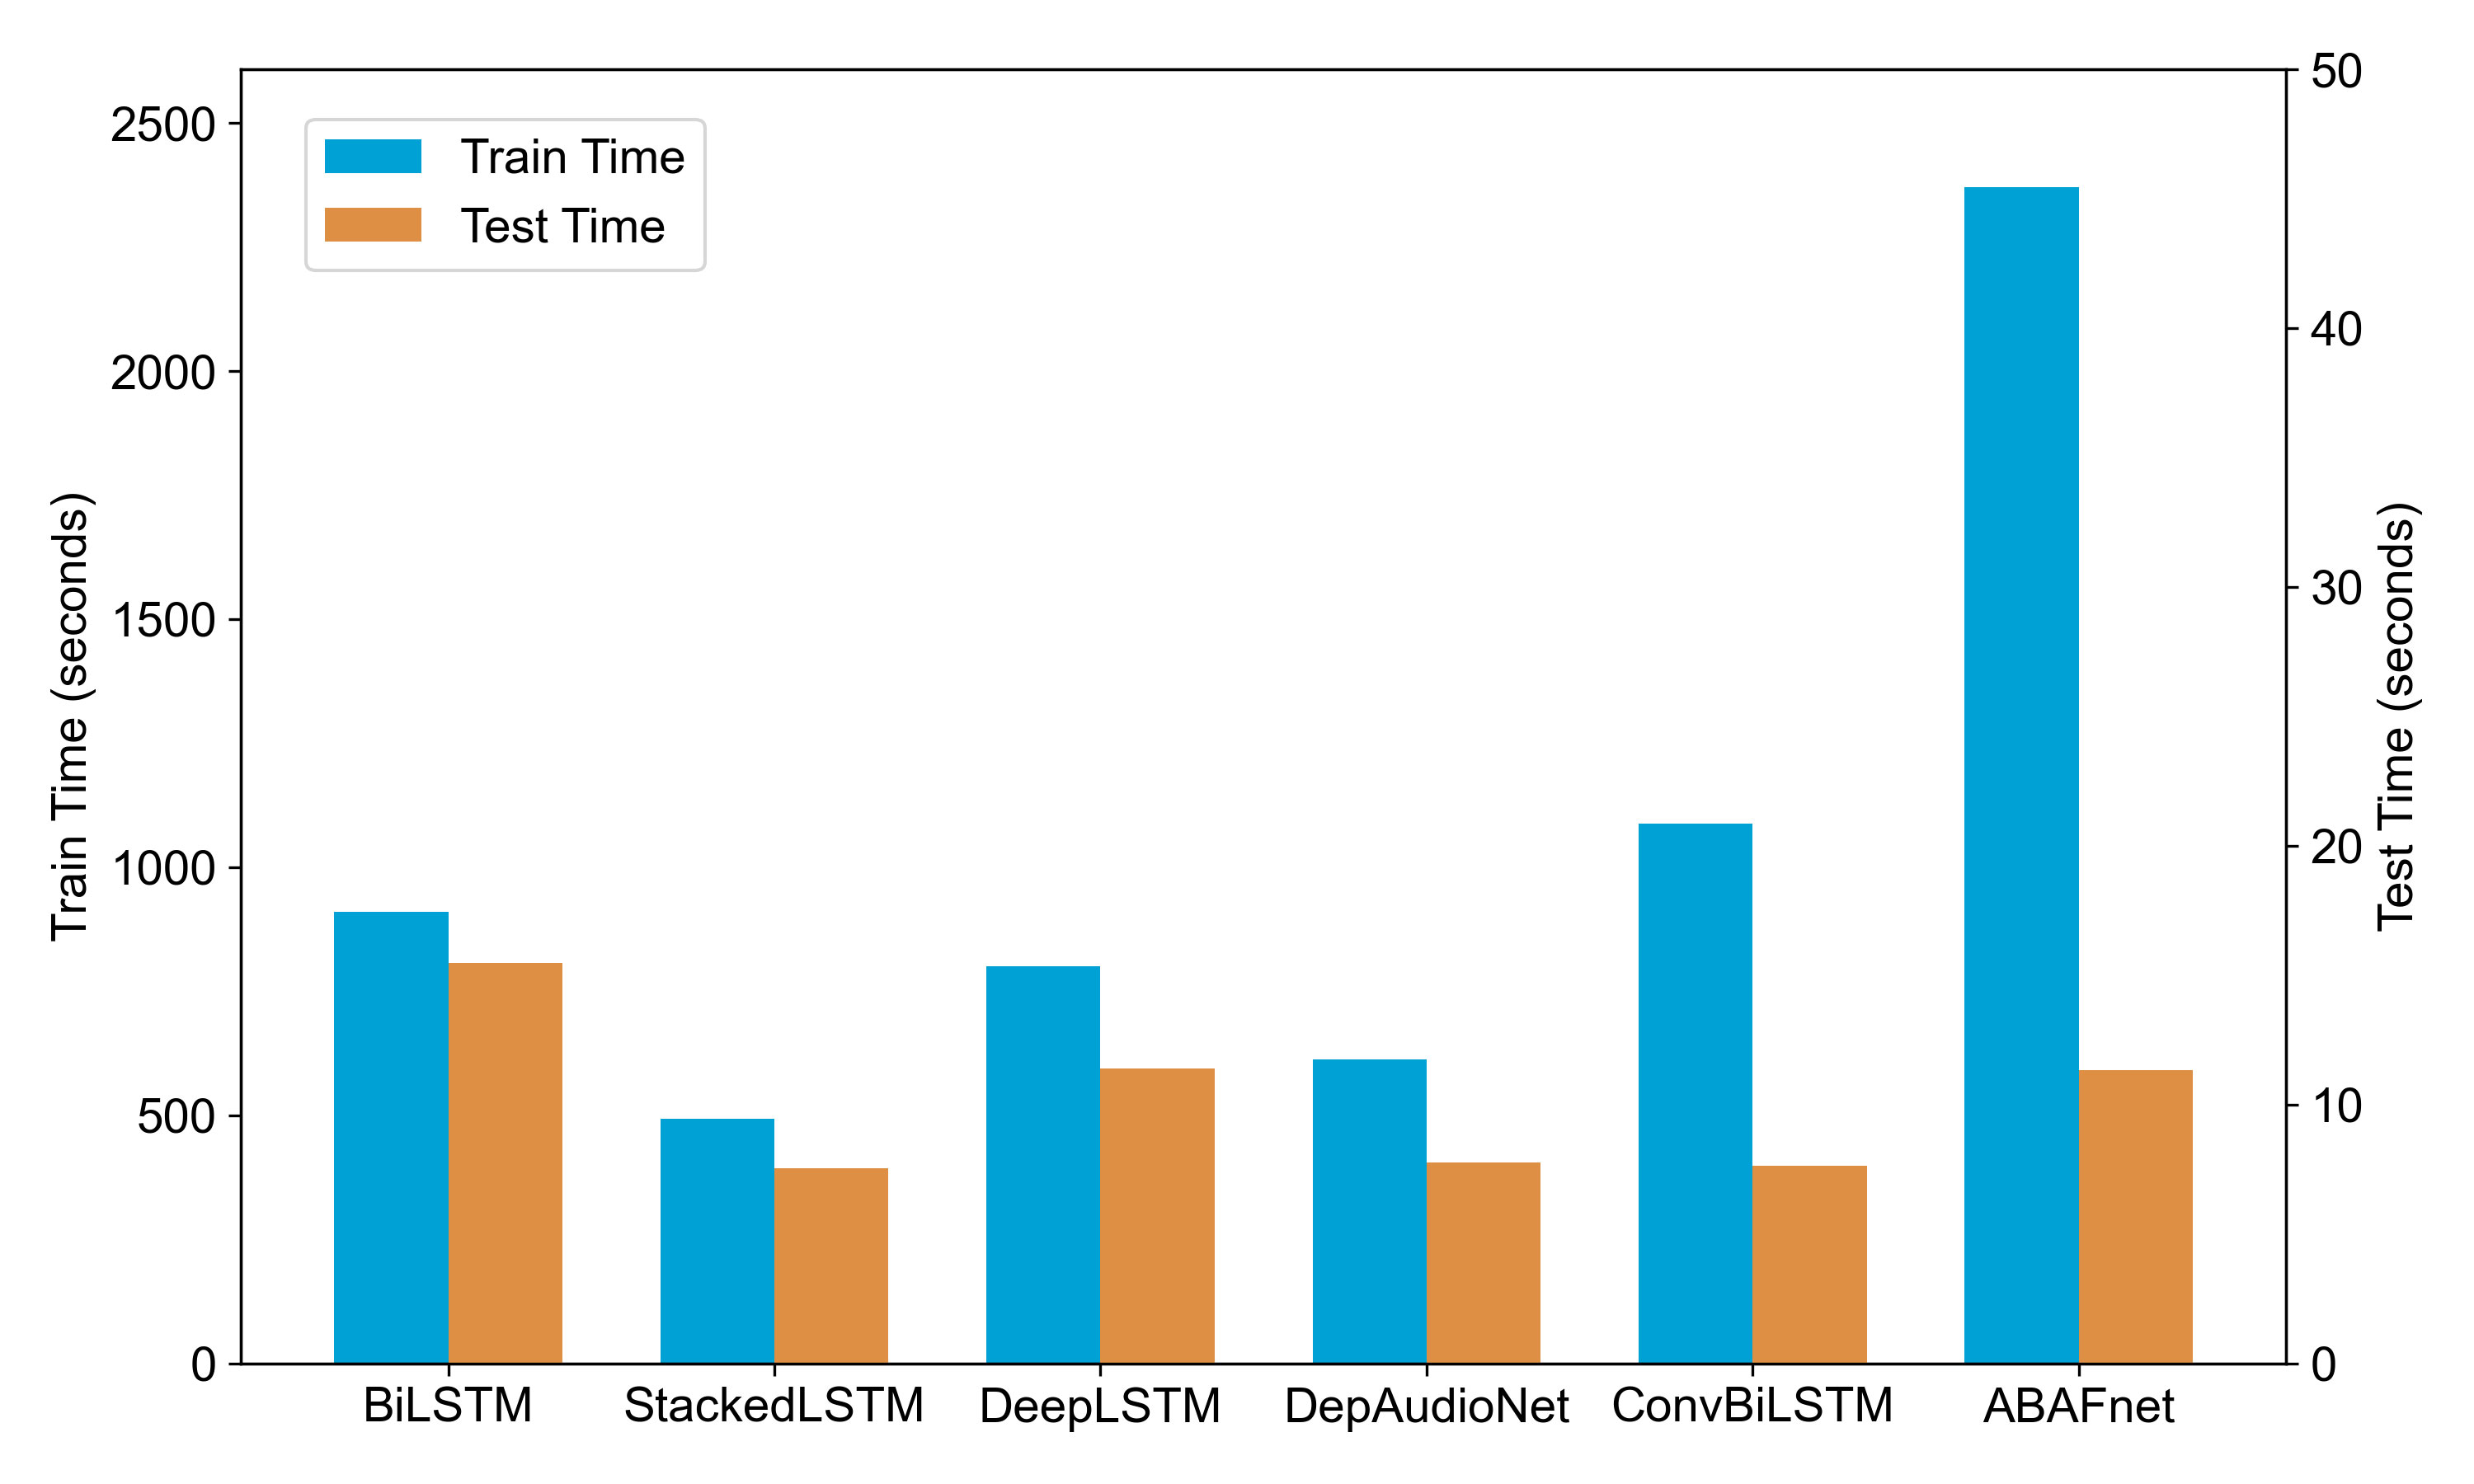
各模型训练/推理时间对比 — 融合的代价是更长的训练时间
不能。这是一项技术验证研究,测试的是 AI 在特定条件下的分类能力。它不等于临床诊断,也不构成医疗建议。如果你正在经历心理困扰,请咨询专业医生。
目前不行。研究使用的是安静环境下的标准化朗读录音(44.1kHz 专业设备),论文没有测试手机录音或嘈杂环境的效果。日常环境的噪声、设备差异等都可能影响结果。
固定文本可以消除"说话内容不同"带来的干扰,让模型更专注于分析说话方式(语调、节奏、能量等)而不是说话内容。就像体检时要求空腹——为了控制无关变量。
这是指模型在 5 折交叉验证中平均正确分类的比例。不是说"你有 81.4% 的概率是抑郁"。它描述的是模型整体的区分能力,不能直接用于个人的概率判断。
消融实验显示梅尔频谱影响最大——去掉它后准确率降幅最大。但每种特征都有贡献:去掉任何一种性能都会下降,说明它们是互补而非冗余的。
可能会。CNRAC 数据集中,抑郁组平均年龄 15 岁,对照组平均年龄 27 岁,差异显著。声音特征本身会随年龄变化,论文未报告校正分析,这是需要注意的混淆因素。
论文提供了代码仓库地址。原始数据需要联系通讯作者申请获取。
Voice Activity Detection
自动找出录音里"真正在说话"的部分,去掉静音和噪声。就像把视频里的废话剪掉,只留有价值的片段。
Mel-Spectrogram
用更接近人耳听觉习惯的刻度来表示声音的频率分布。人耳对低频更敏感——梅尔谱就反映了这种"偏好"。
Mel-Frequency Cepstral Coefficients
从梅尔谱进一步提取的紧凑特征,常被称为"声音指纹"。在本研究的显著差异特征中占比最高(43.75%)。
Convolutional Neural Network
擅长从"图像型"输入中提取局部纹理和模式。就像用放大镜扫描频谱图,寻找有规律的特征。
Long Short-Term Memory
能记住前面的信息来理解后面的内容。就像读文章时记住上一段的要点来理解下一段。
Attention Mechanism
让模型自动"聚焦"到更关键的信息上。就像在一堆文件里用荧光笔标出重点段落。
Late Fusion
先让每个子模型独立给出判断,最后再把判断结果加权合并。相对于在早期就混合特征的"早期融合"方案。
Area Under ROC Curve
衡量分类器在不同判断阈值下的整体表现。数值越接近 1,说明模型区分能力越强。0.847 是比较好的成绩。